当模型可以开源即用、算力可以按需购买,真正决定 AI 能不能干活、干得对不对的,往往是你喂给它的数据靠不靠谱。
最近半年,我们见了太多企业在 AI 上栽跟头。
老板一拍板,大模型安排上,智能问答 Agent 搭起来,号称要让全员自助取数。
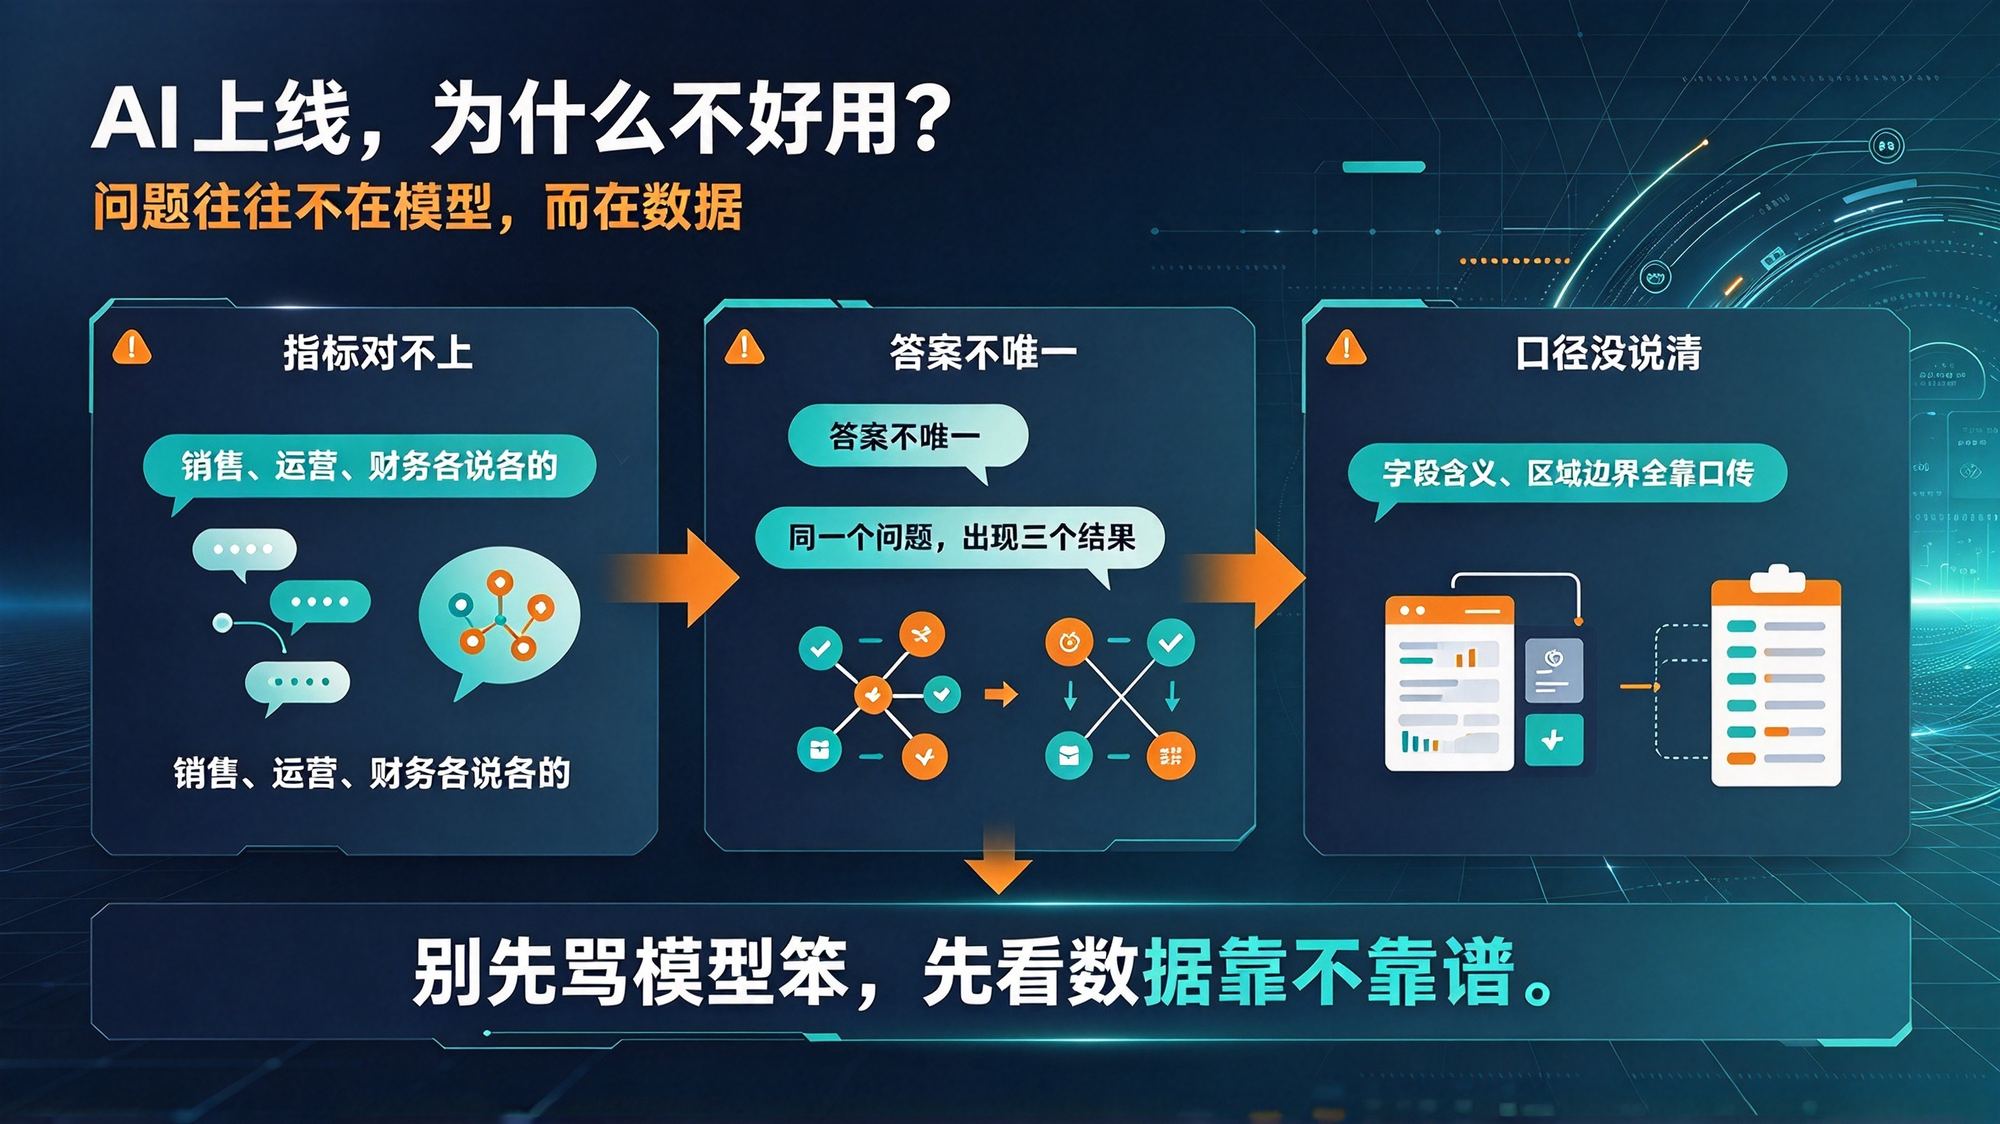
结果上线没两个月,吐槽满天飞:销售说 AI 算的流失率和运营部对不上,财务说 AI 报的营收跟报表差一大截;连"北区销售额"这种基础问题,它都能给出三个答案——因为它连"北区"包不包含东北都不知道。
回头是骂模型笨,还是骂技术团队不给力?真不是。
把底层数据扒开看就懂了:表名字母缩写满天飞,字段含义全靠老员工口传,同一个指标各部门各算各的,连最常见的 amt 字段到底是含税还是实收,都没个准话。
DataHunter 服务过上千家企业,想说一句真话:AI 走到今天,卡脖子的早就不是模型能力,而是数据治理。
模型开源就能用,算力按需就能买,真正决定你家 AI 能不能干活、干得对不对的,是你喂给它的数据靠不靠谱。
如果你也正为"基础数据混乱、数据用不起来"发愁,我们梳理了一份《企业数据治理落地优先级清单》:
清单内含 100+ 中小企业真实实操案例,结合你的业务场景,看哪些数据该先治、哪些 AI 项目该先绑定:从数据体检、标准搭建到质控闭环,一步步拆清"先做什么、再做什么",帮你避开盲目治理的坑,让每一分投入都落地见效。
扫描下方二维码即可领取
01 根本问题:数据的消费者变了,旧体系从根上不成立
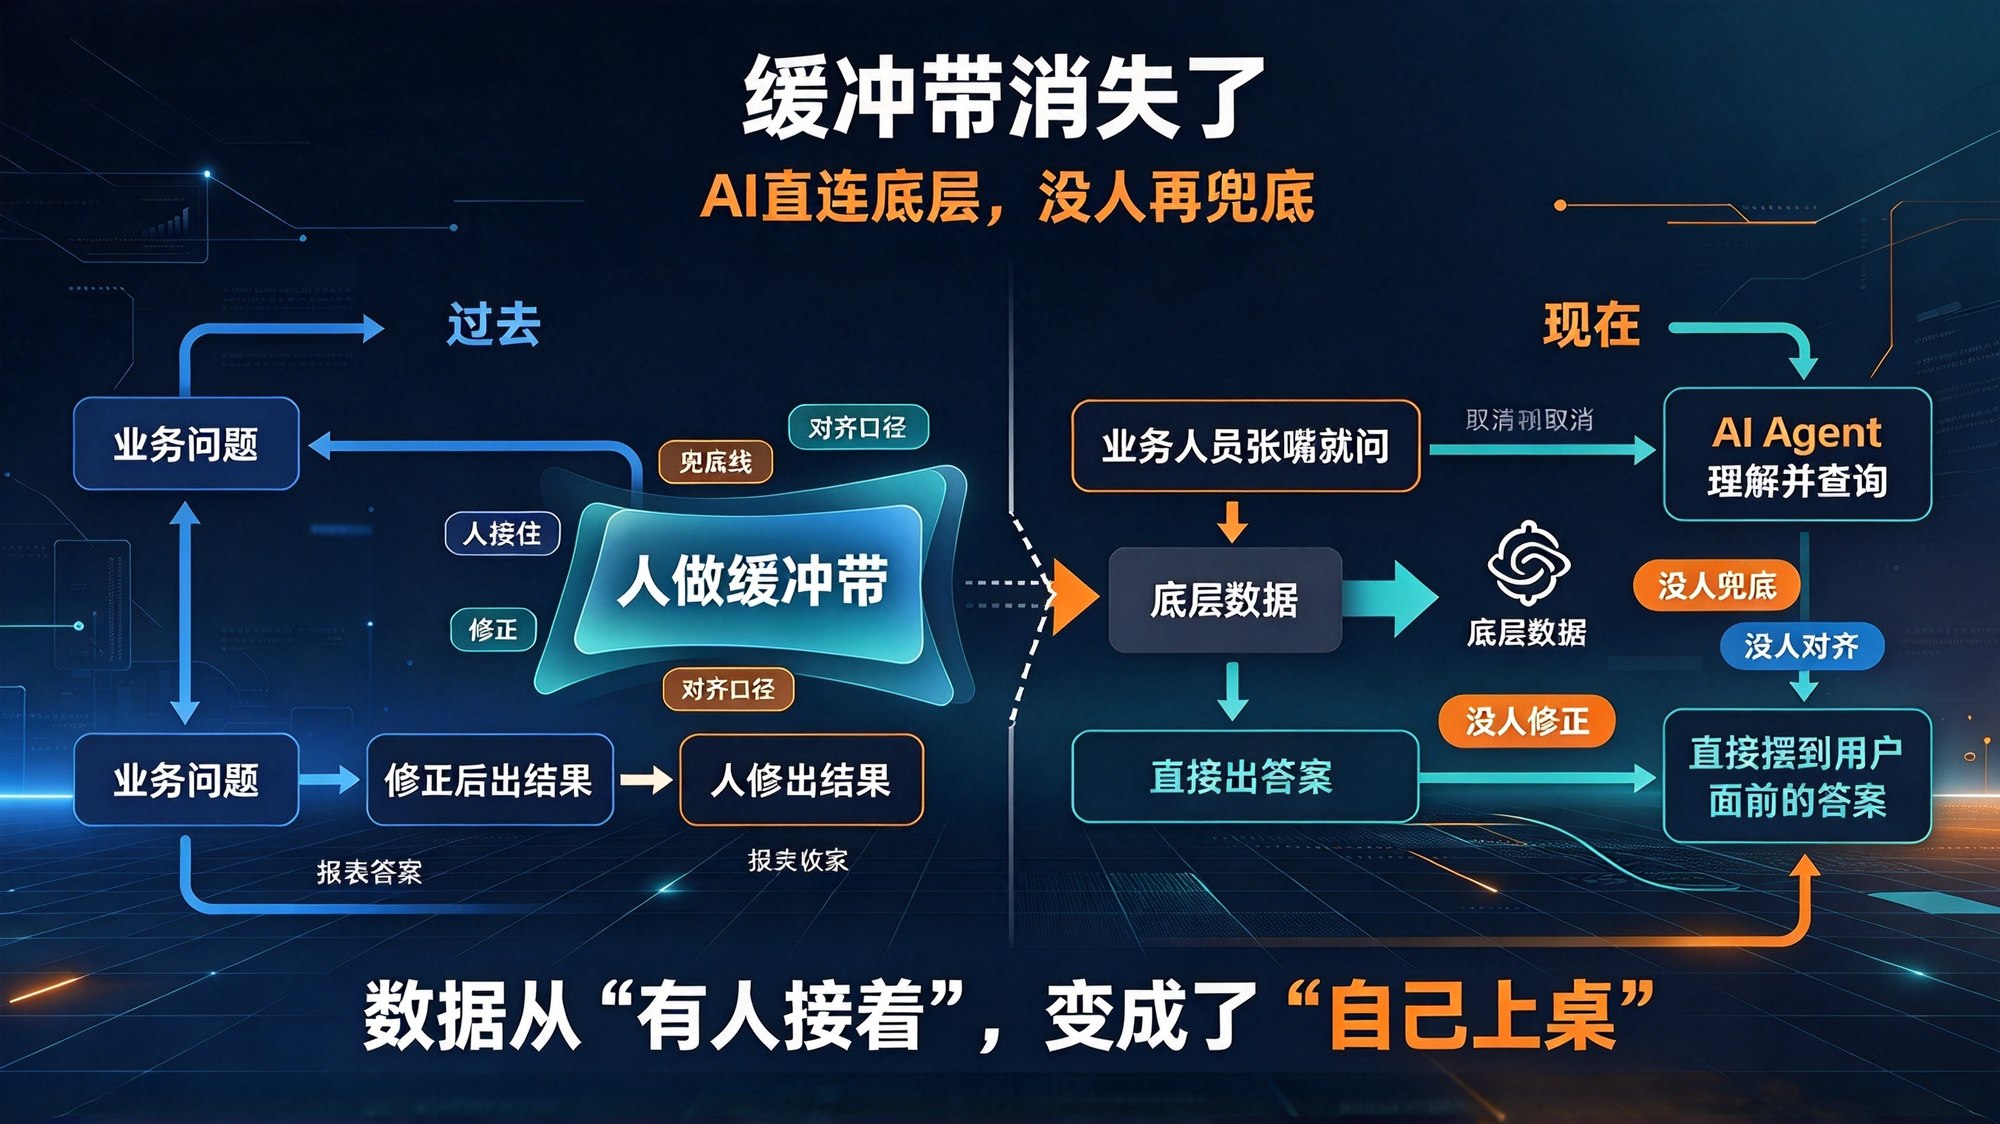
过去十年,企业的数据治理,基本都是围绕"人"来设计的。数据从数仓交到用户手上,中间一直有人"接着"。
这条链路大家很熟:开发写 SQL,分析师做报表,业务看 Dashboard。
字段不规范,开发写 SQL 的时候顺手改掉;口径不统一,开会对齐也就过去了;数字有点小毛病,人自己消化掉。
反正最后递到业务面前的,都是整理好的报表和看板,底层乱一点,没人在乎,也感知不到。
人,就是这套体系的缓冲带。
但 AI Agent 一来,直接把这层"翻译层"拿掉了。
业务人员张嘴就问,AI 直接去查底层数据,中间没人兜底、没人修正、没人对齐口径。
以前藏在水面下的问题,现在全变成了直接摆到用户面前的错误答案。
这不是优化的问题,而是整个底层假设都变了:数据从"有人接着",变成了"自己上桌"。
所以这一轮要重做的,不是数据治理本身,而是它的验收对象变了:过去交给人验收,现在交给大模型验收。考卷换了,答法自然得换。
02 五个扎心现实:传统治理为什么在大模型时代不好使了
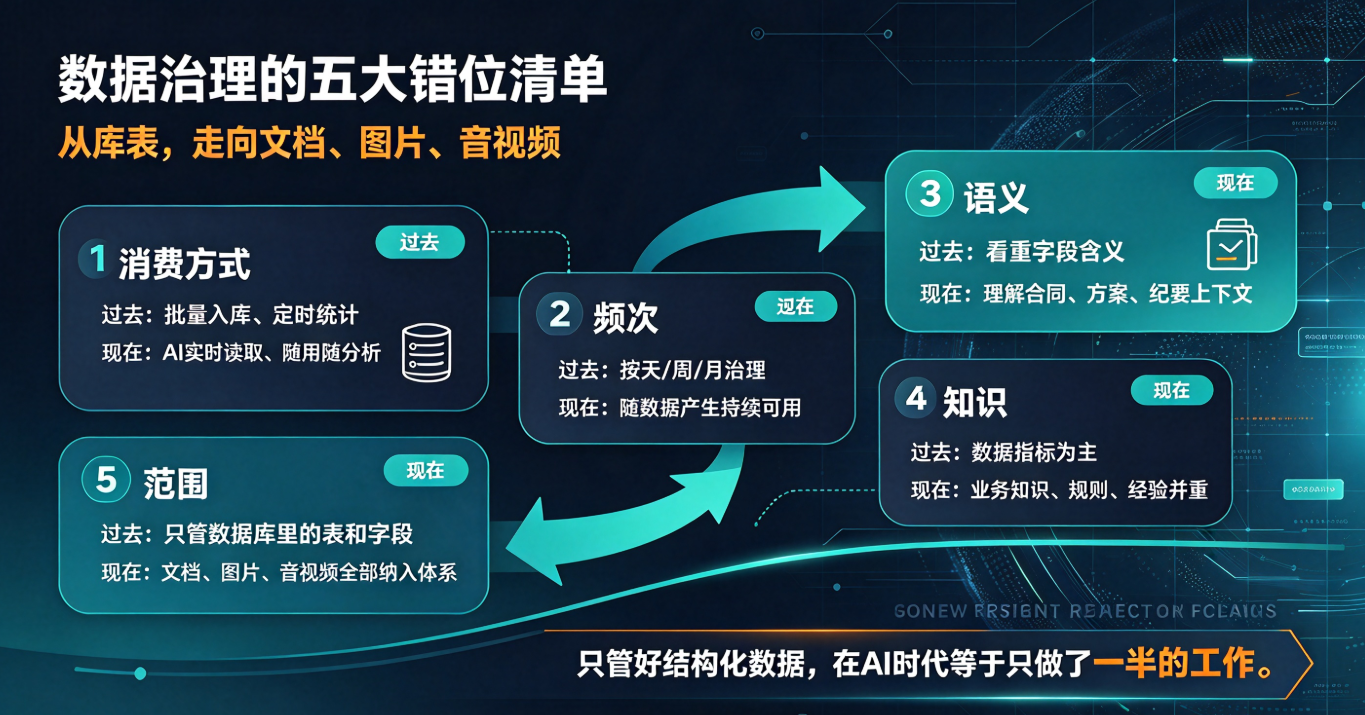
聊了几十家企业的踩坑经历,五个变化最明显,每一个都在倒逼治理重做一遍。
传统治理的每个动作,都是为"最后总有一个人会读懂"设计的:资产目录给人查,口径手册给人读,质量报告给人签。
问题在于,机器不读手册,它只认定义。
变化一:消费方式,从"人看报表"到"AI 直连数据"
传统治理的质量底线是"能跑通"。空值、异常值、历史遗留问题,只要不影响报表,都能往后放。但 AI 不吃这一套。
它直连最底层的数据:字段缺个说明,它就敢瞎猜;口径没统一定义,它就敢乱算;数据里有错误,它输出的结论就错得理直气壮。
过去的瑕疵是"内部问题",现在的错误是"业务事故"。
数据质量的标准,直接从"开发可用"被拉到了"业务可信",要求高了不止一个档次。
变化二:消费频次,从"一天看一次"到"一秒查十次"
以前数据消费是低频的:早上例会看一眼日报,月底复盘拉一次月报,最高频也不过上班刷一下看板。
现在 AI 是 7×24 小时在线:客服 Agent 接客户要实时查画像,销售 Agent 做预测要不停算数据,运营 Agent 盯指标要全天候跑。
一个企业几十上百个 Agent 一起转,查询量是过去的几十上百倍。
数据不再是"存着看"的资产,变成了"随时调用"的服务。
没有标准化接口、没有服务等级保障、没有限流监控,根本扛不住这种调用量。
变化三:语义要求,从"人能意会就行"到"机器得看懂才算"
这是最隐蔽也最致命的一点。
每个公司数仓里,都有一堆"公开的秘密":dwd_order_di 是什么、amt 代表什么、"活跃用户"怎么定义……老员工都懂,从来不用写下来,因为"大家都知道"。
但AI 是个不会问、只会猜的新员工。你不写清楚,它就真的不懂。
没有结构化的元数据、没有明确的口径定义、没有清晰的业务含义,再强的大模型,对着一堆缩写和行话也只能抓瞎。
变化四:知识载体,从"靠人记经验"到"靠结构化知识"
很多业务知识根本不在文档里,在老张的脑子里、在飞书的历史消息里。新人上手要半年,AI 没有这个时间。
它每算一个指标,都得知道完整逻辑:流失率按 30 天还是 90 天?同比要不要剔除节假日?
缺了这些,它吐出来的就是一个干巴巴、来路不明的数字。业务知识,得跟数据一样被结构化。
变化五:治理范围,从"只管结构化"到"全模态都要管"
过去数据治理基本只管数据库里的表和字段。
合同、方案、会议纪要、产品资料这些非结构化数据,因为处理成本高、价值不好算,基本没人管。
大模型把这笔账推翻了:现在 AI 能读合同、拆纪要、分析产品文档,这些非结构化信息的业务价值,一点不比数字低。
治理的边界必须扩,文档、图片、音视频都得纳入体系,都得能被 AI 找到、读懂、用好。
只管好结构化数据,在 AI 时代等于只做了一半的工作。
03 破局三个方向:治理体系,该面向 AI 重做了
坑说完了,怎么改?结合服务上千家企业的经验,核心是三个方向。
先讲清楚每个方向要解决什么问题,再看平台如何承接,而不是一上来堆功能。
方向一:先补语义层,让 AI 不用猜就能读懂数据
很多企业做治理,上来就洗数据、整表,其实最该先做的,是给数据装上"AI 能看懂的说明书"。
字段名是缩写、指标没定义、口径不统一,是 AI 答错问题的头号原因。靠人一个个写文档、对齐,不仅慢,也跟不上业务变化。
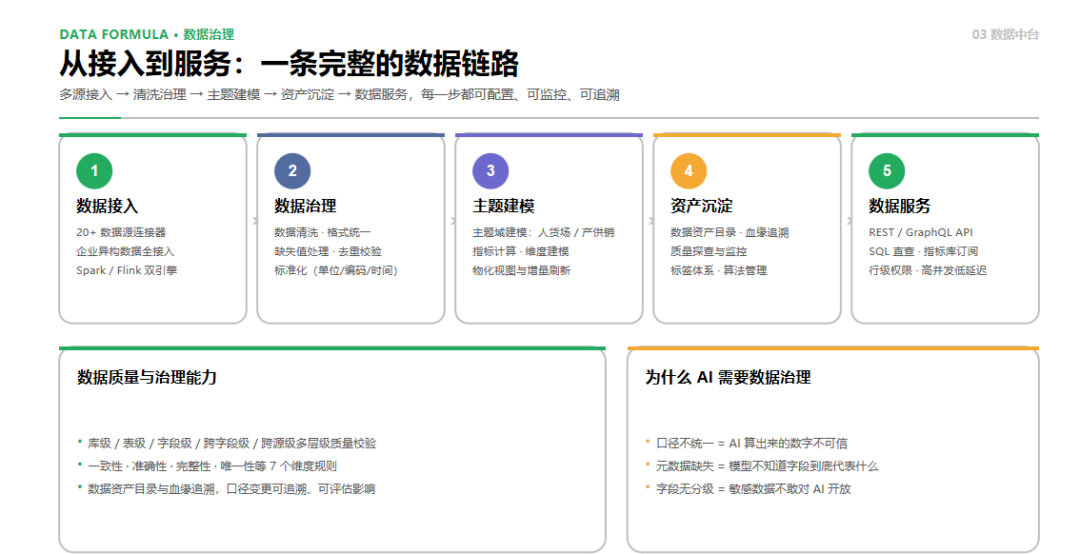
这件事需要一套企业级语义层来承接:把核心业务表的每个字段补全中文名、业务含义、计算口径;让"销售额""流失率""活跃用户"这类概念在全公司只有一个定义,从根源消除二义性;再自动梳理表与表的关联、指标的派生关系,形成一张 AI 能顺着逻辑走的"数据地图",而不是让它自己瞎猜。
这正是 DataFormula 的核心能力之一:平台内置标准化元数据管理体系,统一全公司指标口径,并自动梳理表间关联与指标派生,生成可视化的数据关系图谱,相当于给 AI 配了一张可直接导航的数据地图。
方向二:把非结构化数据纳进来,别让 AI 有盲区
很多企业的 AI 只能查数仓里的数字,合同、方案、会议纪要散在各部门,AI 找不到、读不懂;靠人工整理,更新又跟不上。
这件事要先搭通一条标准链路:文档解析、内容切片、向量化、索引,让散落在各处的材料变成 AI 可检索、可引用的知识片段,而不是单独再搭一套拼凑的链路。
Data Formula 把非结构化数据纳入同一套治理:内置文档解析、内容切片、向量化、索引的全链路,合同、财报、产品手册放进去,自动拆成 AI 可检索的知识片段,并能和结构化数据挂上钩,让一份客户合同关联到 CRM 里这个客户的全部记录。
方向三:把数据变成服务,让 AI 像调接口一样安心用数
AI 用数据是"实时调"的,查询量翻几十上百倍。没有标准化接口,要么扛不住并发,要么权限混乱。
更要紧的是,AI 只拿到数字、不懂业务逻辑,结论很容易脱离语境。
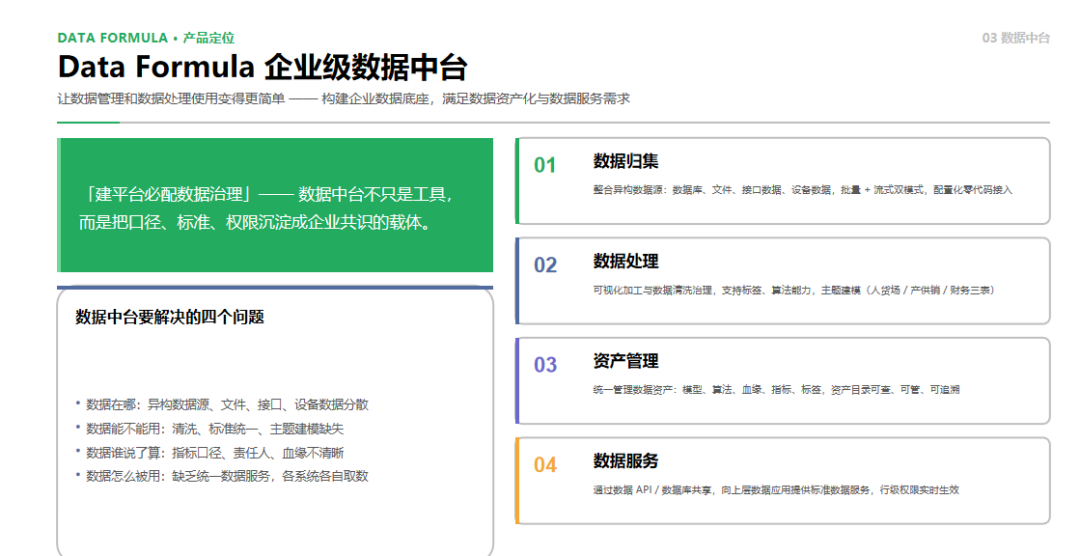
核心数据资产要封装成可调用的标准服务,配访问控制、限流、监控、版本管理,像运维一套系统那样运维它;AI 发一次查询,不仅要拿到数,还要拿到理解这个数所需的全部背景。
Data Formula 把核心数据资产直接封装成可调用的标准化服务:一键生成接口,自带权限管控、服务等级保障、限流监控和版本管理,上百个 Agent 同时调用也稳。
04 别追求完美,先跑通价值
很多企业一提到治理,就想做全量、做完美,其实没必要。治理不是目的,用起来才是。
历史数据债务重,就先治 AI 高频使用的核心表和核心指标;跨部门协同难,就先从一个业务线、一个 AI 场景试点;非结构化没经验,就先从合同、财报这种标准化文档入手。
用看得见的指标先证明价值,比一上来搞大工程靠谱。
传统治理交给你的是"干净的数据",现在要交的是"能用、好用、敢用"的数据。
从行业标准看,这件事也正在从企业的选择题变成必答题:DCMM 2.0 已把"能否支撑 AI"纳入数据治理能力评价,数据治理的合格线,正从"人看得懂"转向"机器读得懂"。
写在最后
做数据治理这么多年,我们最深的感受是:数据治理从来不是为了"管"而做,而是为了"用"而做。
AI 时代,"用"的主体从人变成了 AI,治理的逻辑、工具的形态,自然都要跟着变。
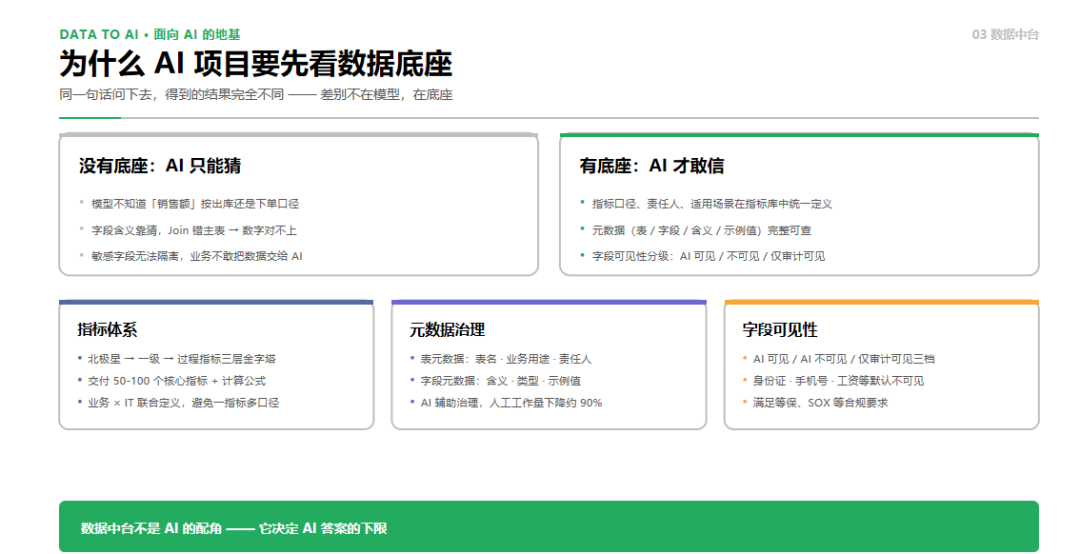
传统治理工具是给人做管理用的,而 Data Formula 从设计之初就面向 AI 场景,提供从数据归集、处理、治理、数据服务到资产管理的全链路能力,从语义层、全模态、服务化三个底层维度,帮你搭一套适配 AI 的新一代数据治理体系。
说到底,AI 从来不是什么银弹,它是个放大器。好的数据治理,能让 AI 的价值成倍放大;烂的数据基础,也会让 AI 的错误成倍放大。
如果你正在筹备大模型项目,不妨先从高频场景做一次数据体检。
我们整理的《企业数据治理落地优先级清单》,覆盖数据体检、标准搭建、质控闭环和优先级排序,帮你在投入前看清"先治什么、先绑哪个 AI 场景",避开盲目全量治理的坑。扫描下方二维码即可领取