这两年企业上知识库,路径几乎一模一样。
买模型、接接口、把文档往里一传,发现不够用,就再上一个 LLM wiki 做编译。所有人都觉得,AI 用得深一点,问题就解决了。
结果呢?
问制度,引用的是三年前废止的版本。问参数,张口就来一个查无此处的数字。问一句稍复杂的规则,答得头头是道,翻遍原文找不到一句支撑。
出了问题,归因高度一致。模型不够强,换更大的。检索不准,换向量库。还嫌不够自动,就上编译。
但我们在 DataHunter 见过上百家企业的知识库从上线走到荒废,想说句真话。
九成的知识库项目,不是败给了模型,也不是败给了自动化不够高,是败给了动手之前没人把规矩定下来。
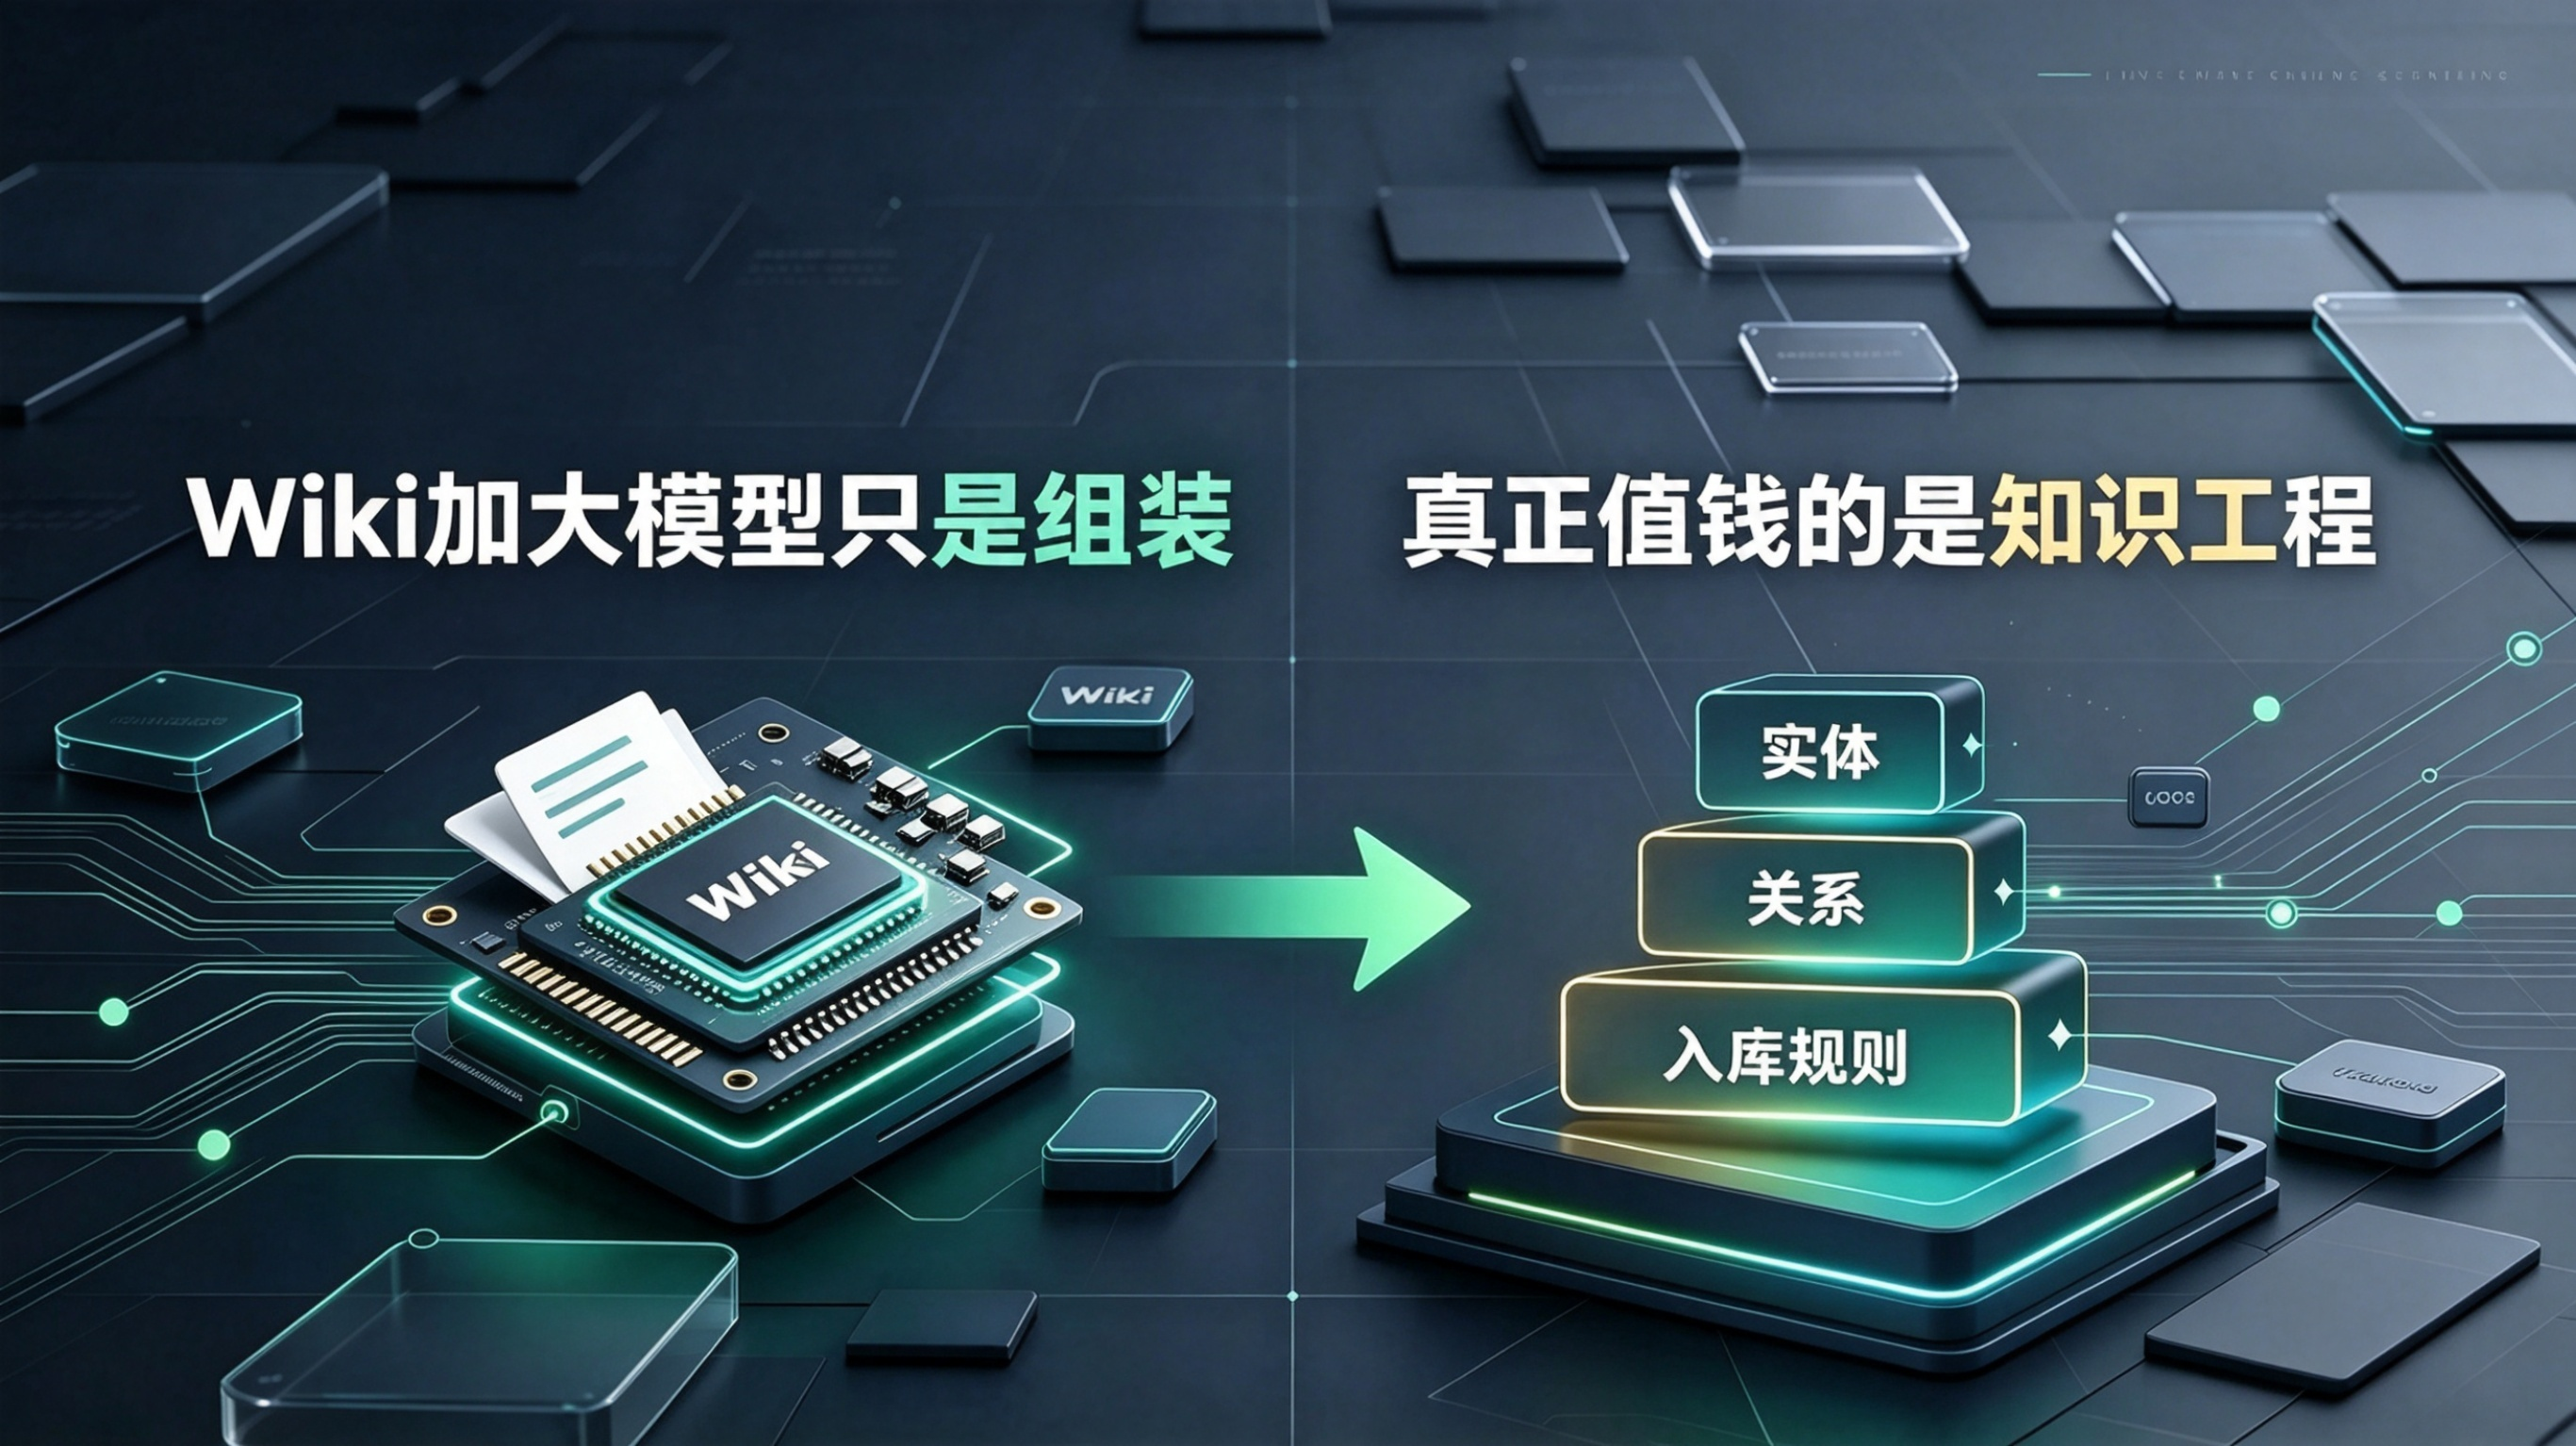
这里说的规矩不是制度文件,是三样能被机器执行的东西:这个领域有哪些东西、这些实体之间允许有哪几种关系、一条内容凭什么能进库。
这三样定不死,编译跑得越快,错得越整齐。
如果你也正卡在这一步,我们把这几年的落地路径整理成了一份《企业知识工程落地清单》,先定什么、后做什么都拆开了,扫描下方二维码免费领
01 先把话说公道:LLM wiki 确实解决了一个大问题
先说清楚这条路好在哪,不然就成抬杠了。
LLM wiki 的做法是,在你开口提问之前,先让大模型把文档读一遍,理解、提炼、关联,整理成一页页结构化的知识。以后谁来问,直接读这一页,不用每次临时拼接。
打个比方。传统检索是开卷考试,每次现场翻书,翻到哪页算哪页。编译是先把书读完、做好笔记,考试直接看笔记。
这个进步有多大。以前每次问答,模型面对的是一堆被切碎的段落,像一堆剪碎的报纸,得在碎片里拼出一个答案。现在模型面对的是一页整理好的笔记,上下文是完整的。
而且预制出来的东西带着来源信息,能点回原文,所以溯源这条路是通的。这一点很关键,后面还要用到。
LLM wiki 其实已经证明了一件更重要的事:知识可以提前理解好。
以前都是查的时候才去理解,现在是存的时候就理解完了。这个思路上的转身,本身就有价值。
所以问题从来不是要不要编译。
02 但 LLM wiki 绕过去了一件事
编译的对象是内容,不是规矩。
举三个场景,都是我们在企业里真见过的。
第一个。一个部门写了三年的制度,如果这三年里同一件事有三种说法,LLM wiki 会把三种说法都编进去,而且每一页还很整齐。
第二个。如果某份文档本身就是废止版本,LLM wiki 会连废止一起编译进去,还贴心地标好了出处。
第三个。同一台设备,销售部叫“1号泵”,工程部叫“1#泵”,维修部叫“水泵A”。LLM wiki 会当成三个东西,建三套档案,编出三页互不相干的知识。你问系统这台泵的故障怎么处理,系统只答得出一部分。
这三个场景有个共同点,LLM wiki 没有做错任何事,老老实实把你给的资料读懂了、理顺了、编好了。
问题在于,LLM wiki 不知道哪一句是对的。
LLM wiki 解决的是重复劳动,不是谁对谁错。原文本身就是错的,编译只是把那句错话整理得更工整、更好读、更容易被引用。
以前错在一堆碎片里,还能被人发现。现在是把错装订成册,有了封面、有了目录、有了页码,看上去像本权威著作。
整齐不等于对。可读性提高了,可信性一点没动。
这不是 LLM wiki 的错,错在站的位置本来就不在那个环节。LLM wiki 在编译,而判断对错发生在编译之前。
03 规矩到底是哪三样
编译之前该有什么。三样,一样都不能省。
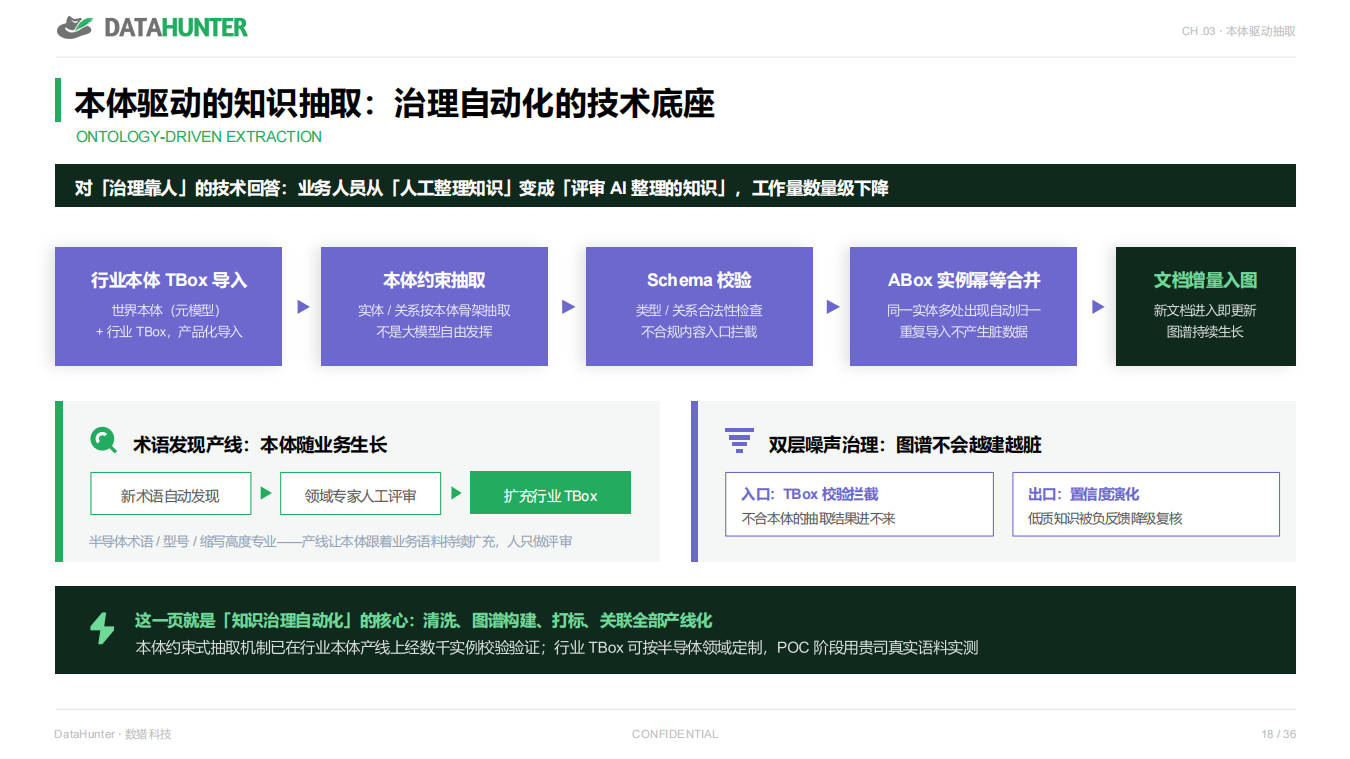
这三样有个专业名字,叫本体。听着玄,其实就是三件事。
第一样,实体。说白了就是“这个东西叫什么”。
做法很朴素。让业务专家把这个领域里到底有哪些东西列一遍。设备、客户、工艺、产品,就这么多,一次列完。
为什么必须先做。因为机器认不出同义词。
人看见“1号泵”“1#泵”“水泵A”,一眼就知道是同一台泵。机器不知道。在机器眼里,这是三个不同的字符串。没人告诉机器,机器就当成三个东西,建三个档案、生成三条关系链、编三页知识。等到检索的时候,谁也拼不出完整答案。
就像公司里给每个人办工牌。同一个人要是办了三张工牌,系统里就成了三个员工,考勤、工资、权限全对不上。
实体定死,就是让机器在入口处归一。不管原文怎么写,落到系统里只有一个身份。这件事做完,那张关系图才可能连通。
第二样,关系。就是“这件事和那件事之间,算什么联系”。
做法是把允许的关系类型列成一个清单,就那么几种,不能自己加。
不限定会怎样。放任大模型自由生成,你会得到一张看起来很密的图。上面写着“导致”“引起”“出现”“相关”,这四个词其实是一个意思,大模型会画成四条线。节点几百个,线几千条,凑近一看全是“这两个词一起出现过”,没有逻辑。
这时候你问系统,这台设备为什么振动超标。系统能顺着这些线走出十条路径,十条都说得通,没有一条能信。
收窄之后,图才有骨架。问一台设备的故障,能顺着固定路径走到处置方案,而不是在一堆线里乱逛。
第三样,审核规则。就是“一条内容凭什么能进库”。
什么算合规、什么算过期、有没有原文依据、依据落在哪一段。这些事如果入库时不定,就只能等出库以后一条条挑,那是永远挑不完的。
我们内部跑的数,大约四分之一自动抽取的关系,在原文里找不到依据。
这个比例其实不算吓人。吓人的是没有这道校验的时候,这些关系会全部直接进库,进去之后你就再也分不清哪些是真的。
规矩不是写在制度文件里的,是写在系统里、违反就进不来的。
04 那为什么不干脆手工梳理一遍
到这里会有人问一个很实在的问题。既然规矩这么关键,找几个专家把规矩手工梳理清楚不就行了,为什么还要费劲搞编译。
不够。这正是上一代知识管理栽跟头的地方。
传统做法是一场专家访谈。把老师傅请来,一条条问、一条条记,梳理三到五个月,产出一套知识库加几本模板。做完就封存。业务在变,没人在意更新,半年之后系统还在,已经没人维护。
问题不在人不认真,在成本。一次完整的梳理要五个专家凑三个月,十五个人月。这个成本决定了手工梳理只能做一次、只能做局部、只能做成一张静态照片。而业务是活的。
所以规矩和编译不是两道工序,是一件事的两半。
规矩是编译的输入。没有规矩,编译没有标准,只能照抄原文,把矛盾原样搬进去。
编译是规矩的规模化执行。没有编译,规矩只能靠人一条条往上套,套完这一批,下一批还得手工。
合起来才成立:人把规矩定一次,机器按这个规矩编译一万次。
这才是“人只判断一次”的物理基础。不是人不愿意多判断,是判断本来就不需要重复那么多次。重复的是执行。
有一家流程工业的上市公司就是这么走的。这家企业没有换模型,做的是把产品资料归到一个源头,一份清单说清哪个版本算数,版本变了自动降级旧的,冲突的地方由业务负责人裁决。现在系统用户六千多,月登录率 90% 以上。这个数字不是功能堆出来的,是员工问十次能对九次半,才会一直问下去。
我们做 Kexis 的时候,顺序也是反的。不是先让 AI 去抽、抽完再挑毛病,是先让人把实体清单和关系清单定下来,再让 AI 在这个框里抽取。抽出来的每一条关系都回原文核对,找不到依据的挡在图外。
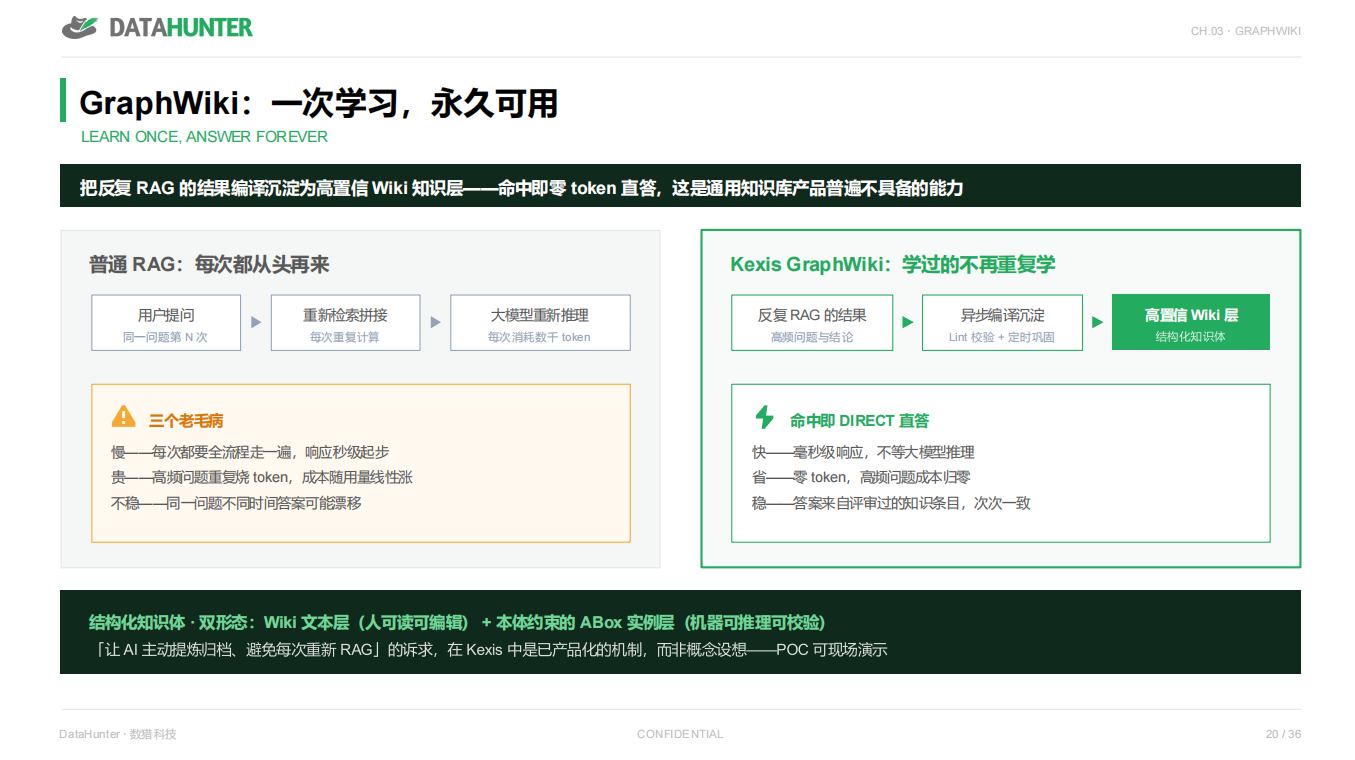
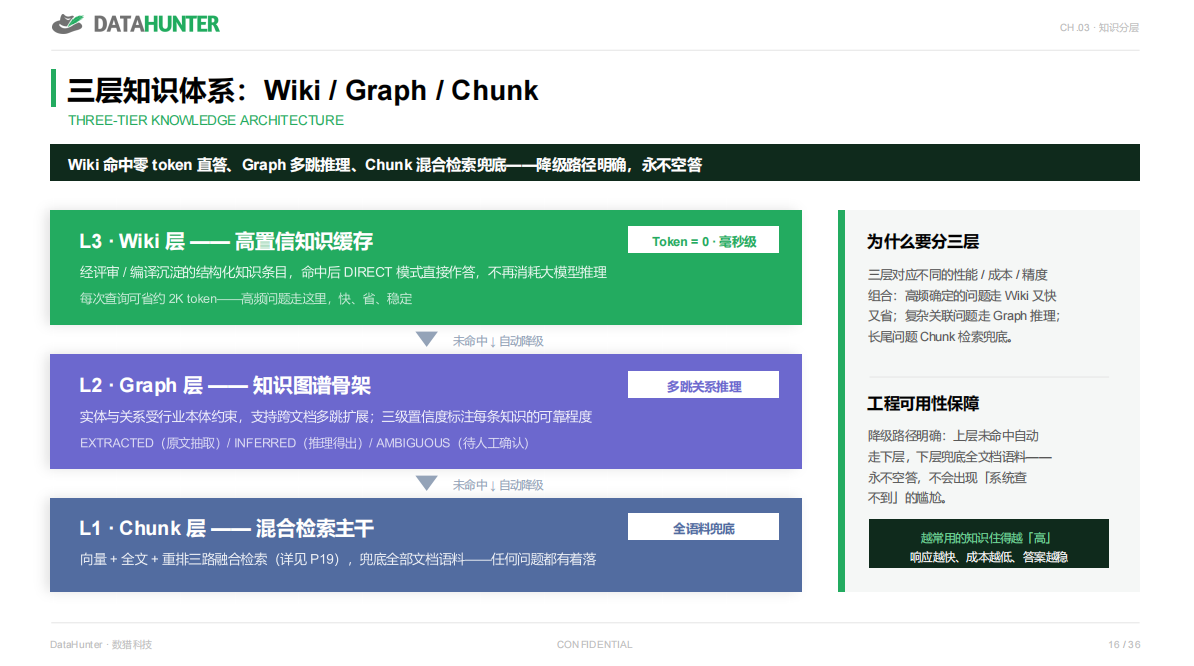
编译沉淀下来的高频结论会固化成一页知识。同一个问题再问,直接读这一页,不用重新推理。这一页没命中,就降级到关系图里顺着线走几步找答案;再没命中,交给最底层的检索,把全部文档翻一遍兜底。三层一路降级,不会出现查不到。这一层在 Kexis 里叫 GraphWiki,一次学习,永久可用。
规矩让编译不出格,编译让规矩跑得起来。
05 人的位置只剩两个
规矩定完、编译跑起来,人的位置就变了。
一条知识从进门到退休,一般要走七步。采集、整理、显性化、评审、发布、演化、退役。其中五步可以交给机器。
但真正需要人的地方,不在流程里。
第一个节点,规则制定。前面那三样,实体清单、关系清单、审核规则,只能人定。而且定一次就长期有效,不需要天天重做。
第二个节点,矛盾裁决。两份文档打架的时候、新旧版本冲突的时候、同一个说法有两种解释的时候,谁说了算。这件事机器永远做不了,因为答案不是算出来的,是有人要承担后果。
这两个节点有个共同点,都是判断,都不常发生。所以人不会成为瓶颈。
很多企业的错误恰恰是反过来。配两三个知识管理员,每周抽检一批答案,以为这样就有人管了。这些管理员做的不是判断,是换个岗位重复劳动。一万份文档、几十万条知识条目,一个人一周抽一百条,抽完要几十年。等抽出来,那条错东西已经被引用了上百次。
所以问题不是要不要人管,是人管在哪一环。
很多制度写得很厚,五类标准一条不缺,最后全落空。因为标准只活在文档里,靠人自觉。自觉这两个字,在月末冲业绩的时候一文不值。
标准只有长在系统里,才叫标准。挂在墙上那叫愿望。
工作量上的差别很实在。一个传统知识管理项目,客户侧要投十五到三十个人月,大头花在人工整理上。治理动作交给平台之后,同样范围能压到五到十个人月。
省下来的不是人力成本,是这件事还能不能持续的成本。
写在最后
没有规矩的 LLM wiki,只是把错误装订成册。
这话不是否定编译。编译能做的事,手工永远做不到。但编译只是放大器,不是发动机。标准清楚,编译把这个标准执行到一万份文档;材料自相矛盾,编译把矛盾原封不动地放大一万倍。
所以顺序一定是,先定实体,再定关系,再定审核规则,然后才是让机器去编译。
判断的成本没有被消灭,也降不到零。只是从每次都要判断,变成只判断一次。
模型决定系统能答多快,自动化决定系统能答多少。只有规矩,决定系统敢不敢让人照着做决定。
知识治理的终点不是无人化。是每个人只在自己不可替代的那一步出现。
如果你也卡在“上线就荒废、没人愿意管”这一步,那份《企业知识工程落地清单》还在,扫描下方二维码免费领