过去两年,企业做知识库的热情,比做任何一件事都高。
买模型、接接口、把文档往里一传,一个“企业大脑”就算上线了。所有人都默认,这一轮拼的是谁的模型更强、谁的检索更准。
结果呢?
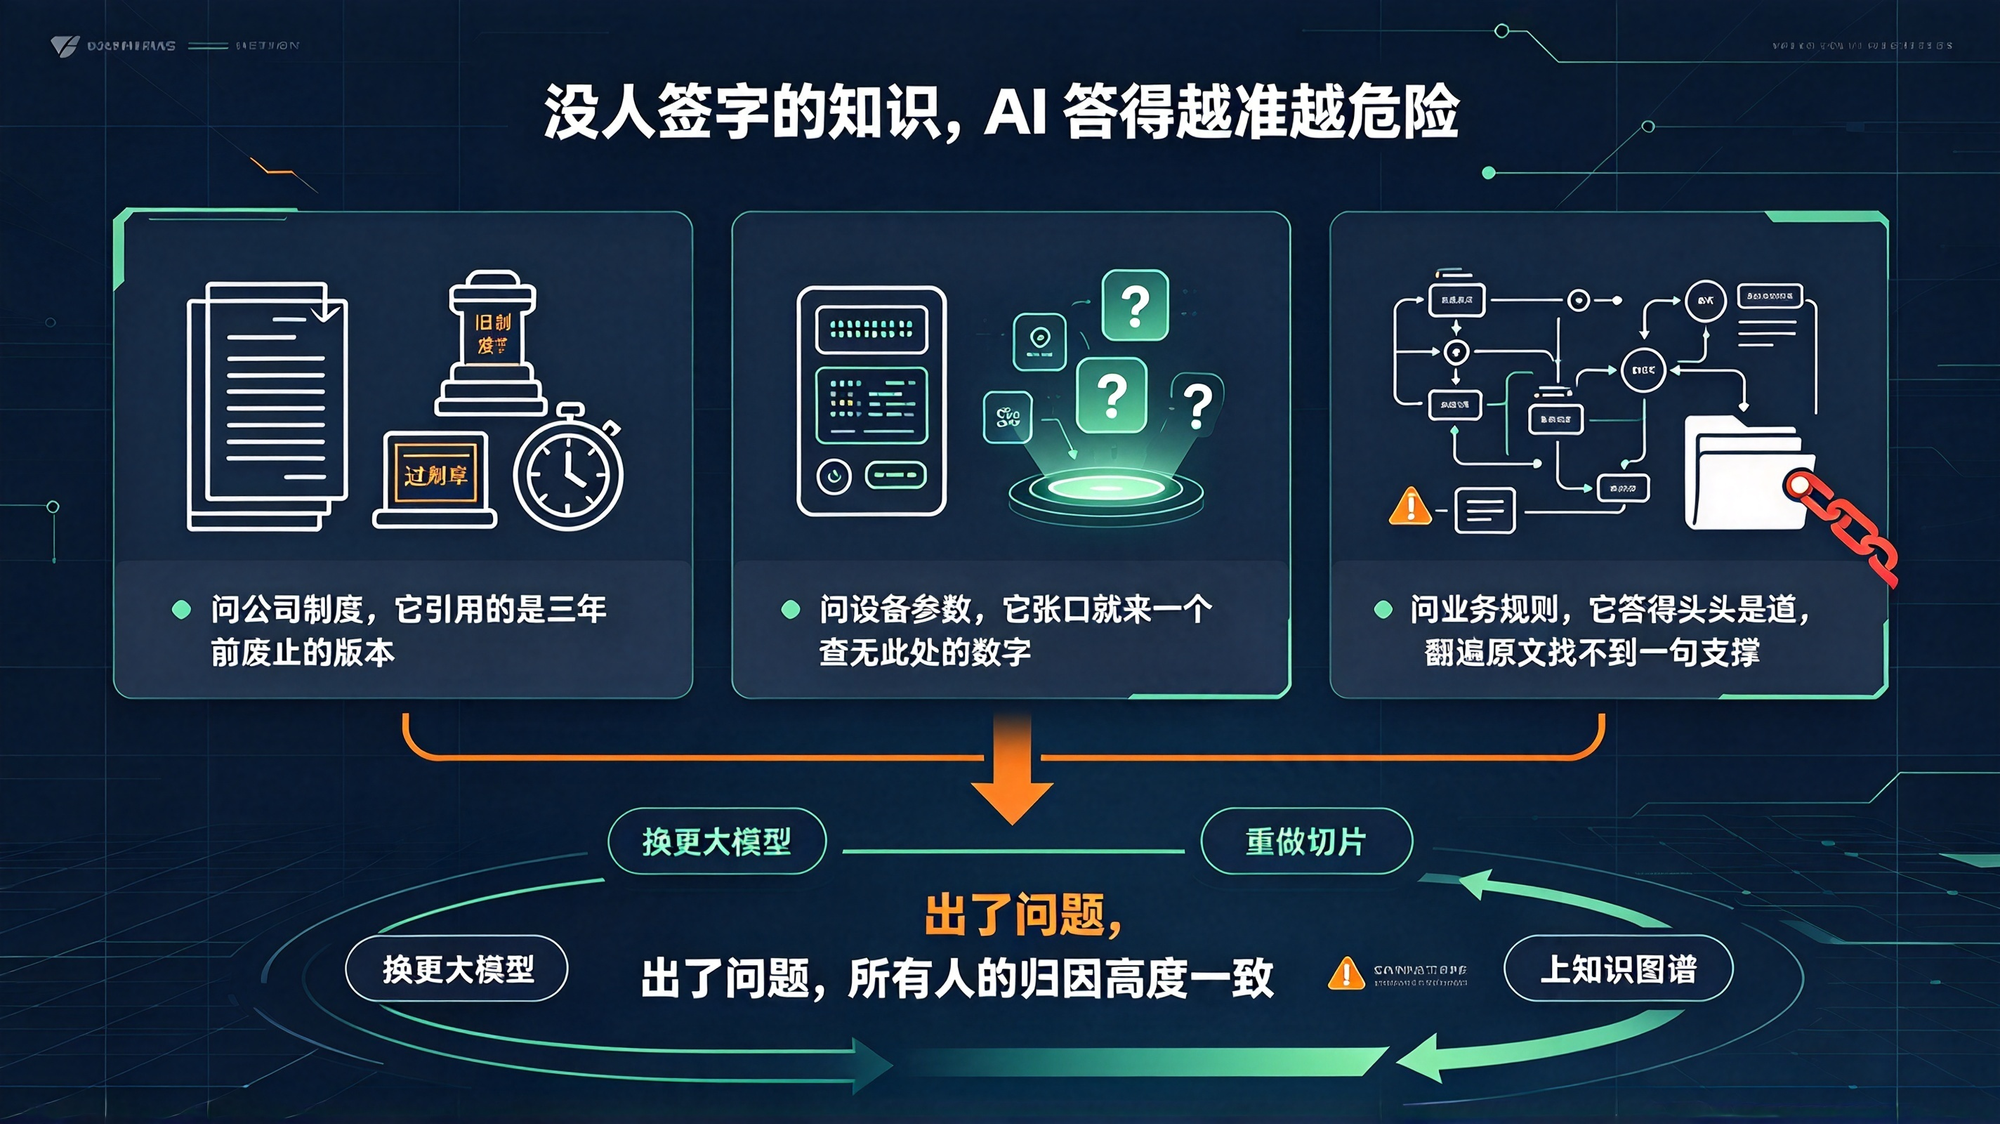
问公司制度,它引用的是三年前废止的版本。问设备参数,它张口就来一个查无此处的数字。问一句稍复杂的业务规则,它答得头头是道,翻遍原文找不到一句支撑。
出了问题,所有人的归因高度一致。模型不够强,那就换更大的。检索不准,那就换向量库。切片不行,那就重做一遍。还不行,那就上知识图谱。
但我们在 DataHunter 见过上百家企业的知识库从立项走到荒废,想说句真话。
90% 的企业知识库,不是死在模型上,也不是死在检索上,是死在从头到尾没有一个真正管它的人。
这句话还不够狠。再往下问一层,为什么没人管?
因为传统知识管理太重了。企业做一轮完整的知识梳理,要 5 位专家凑 3 个月,凑出 15 个人月,产出一套库加几本文档模板。半年之后系统还在,已经没人维护。
这不是认知问题,是成本结构问题。
大模型把整理的成本压掉了九成九。读 1000 份报告,专家要 3 个月,它要 3 小时。可它一分钱都没能压掉“判断”的成本。哪些知识重要,哪条是对的,哪条该撤,一件都没便宜。
过去贵在整理,现在贵在判断。而判断这件事,只能由人来做。
一句没人核对过的答案,答得越快、越顺、越像那么回事,被当成真的概率就越高。这一次,我们只谈这个成本没有降下来的地方。
如果你也正为“知识库上线就荒废”发愁,我们把这几年踩过的坑整理成了一份《企业知识库落地优先级清单》,里面拆了先做什么、后做什么、哪一步可以跳过,扫描下方二维码免费领
一、设备换了几轮,活还是糙
如果问题出在成本结构,那钱都花在哪了。
有一家企业自己复盘过一句话,“我们花百万买的智能知识管理系统,上线 6 个月使用率还不到 20%,最后就当个存文档的硬盘用。”
这句话里最扎人的不是 20%,是“当个硬盘用”。硬盘不需要治理,硬盘只负责存。
设备越买越贵,活越干越糙。
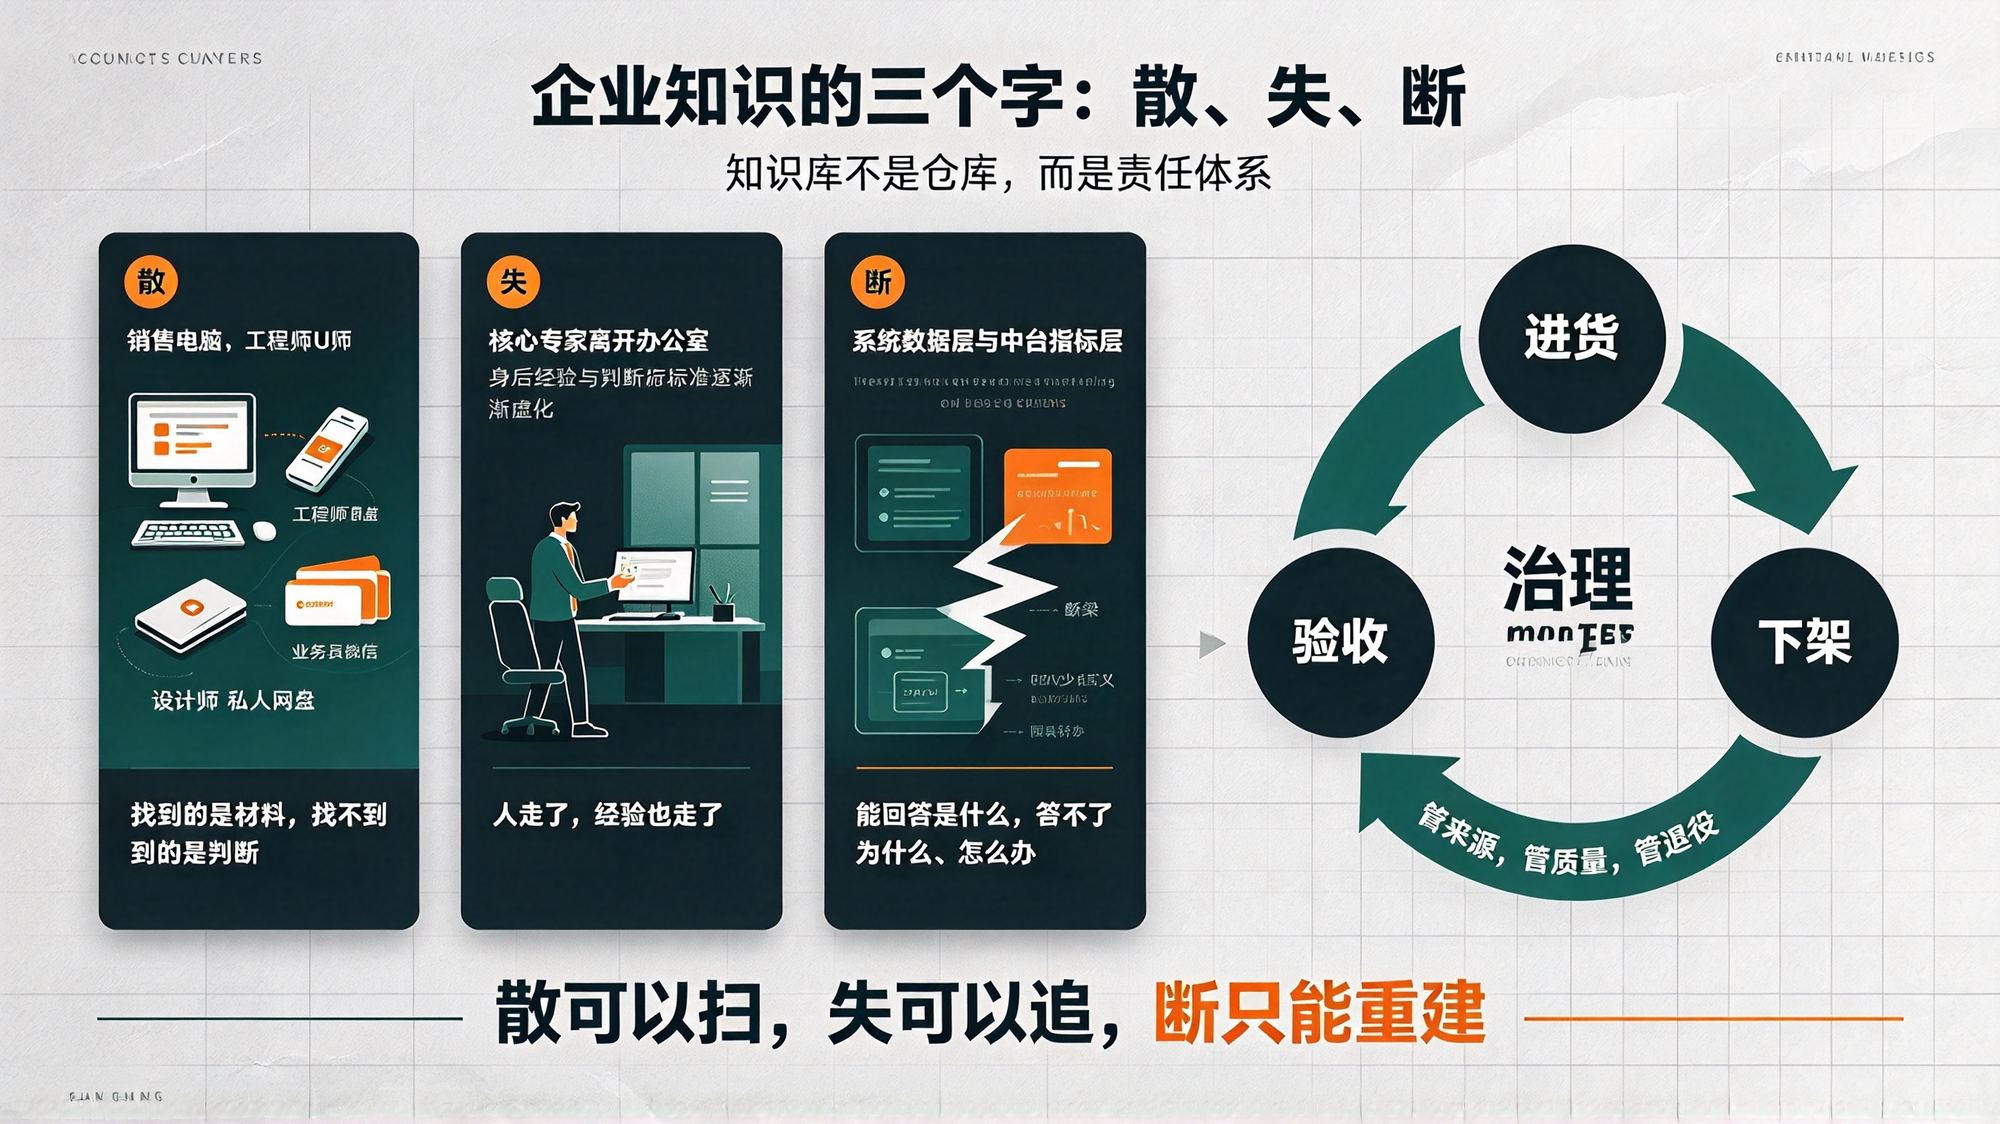
我们在企业里见到的真实情况,基本是三个字。
散:合同在销售的电脑里,项目资料在工程师的 U 盘里,客户资料在业务员的微信里,设计稿在设计师的私人网盘里。找到的是材料,找不到的是判断。
失:核心专家一退休、一流动,业务判断标准跟着一起走。人走了,经验也走了。
断:系统里有数据,中台上有指标,中间缺了语义和因果那一层。它能回答是什么,答不了为什么、怎么办。
三个字里最难补的是断。散可以扫,失可以追,断只能重建。
知识库不是仓库,不是谁往里堆货都行。它得有人管进货,管验收,管下架。
而这三件事,一件都不是技术活。
二、检索调得再准,机器也不知道“1号泵”和“1#泵”是同一个东西
进货这关没人管,大家转头去调检索。
这两年知识库的技术迭代几乎全在检索这一侧。向量改混合,混合加融合排序,融合之后上重排,重排不够上知识图谱。每一步都有效,每一步都能把准确率往上抬几个点。
我们在企业里见过一份设备维护文档。同一台泵,在三个部门的文档里分别写成“1号泵”“1#泵”“水泵A”。人扫一眼就知道是同一个东西,机器不知道。你问它 1 号泵的故障怎么处置,它在写着“水泵A”的那份里找不到,在写着“1#泵”的那份里拼出半条。
但它不会告诉你找不到。它会答。答得还挺像。
这不是检索的问题。检索再准,也只能把你给它的碎片排好序。它不知道什么算同一个东西,因为从来没有人告诉过它。
这一层缺的东西叫语义约束。哪些是核心实体,实体之间有哪几种合法关系,什么情况下这两个说法算同一个。这些不是算法推出来的,是业务专家心里的常识。常识不写下来,机器就只能一直猜。
所以你看到一个很怪的分工。技术团队在拼命优化检索,业务专家在隔壁办公室,一句话没说。
这就是很多知识库项目最真实的死法。不是被技术卡住的,是被一个没人认领的空白卡住的。
检索能帮你搜到十份互相矛盾的文件。谁对,只能来自一个说了算的人。
三、学过一次的知识,不该每次都重新学
还有一种更聪明的做法,这两年很火。
让大模型在你提问之前,先把文档读一遍,编译成一页页结构化的知识。以后谁问,直接读这一页,不再从头检索。方向是对的,把理解从查的时候挪到存的时候。
我们做的Kexis里,这一层叫GraphWiki。同一个问题被反复问,系统把结论异步编译沉淀下来,下次命中就直接返回,不再走一遍大模型推理。常用的问题住得越“高”:高频确定的走编译好的知识页,零 token,毫秒级;复杂关联的走图谱做多跳推理;长尾的交给混合检索兜底。三层逐级降级,不会出现查不到。
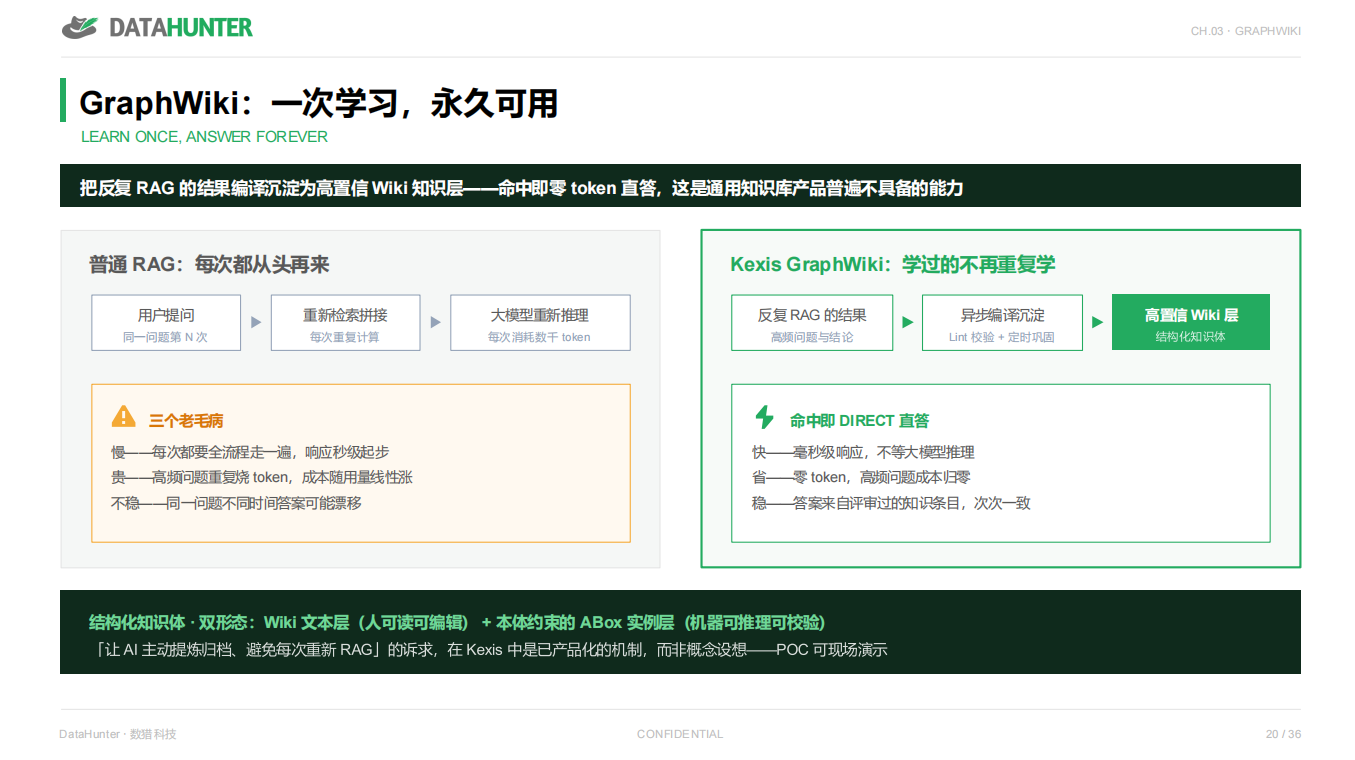
快、省、稳,三个好处都是真的。
但它没有回答下一个问题。
编译出来的那一页,谁签字?如果原文本身就是错的,编译只是把错的那句话整理得更整齐、更好读、更容易被引用。
以前是错在一堆碎片里,现在是把错装订成册。
沉淀能解决重复劳动,解决不了谁对谁错。
四、真正的死因不是答错,是答错了三个月没人发现
谁对谁错这件事,大部分知识库没有设岗。
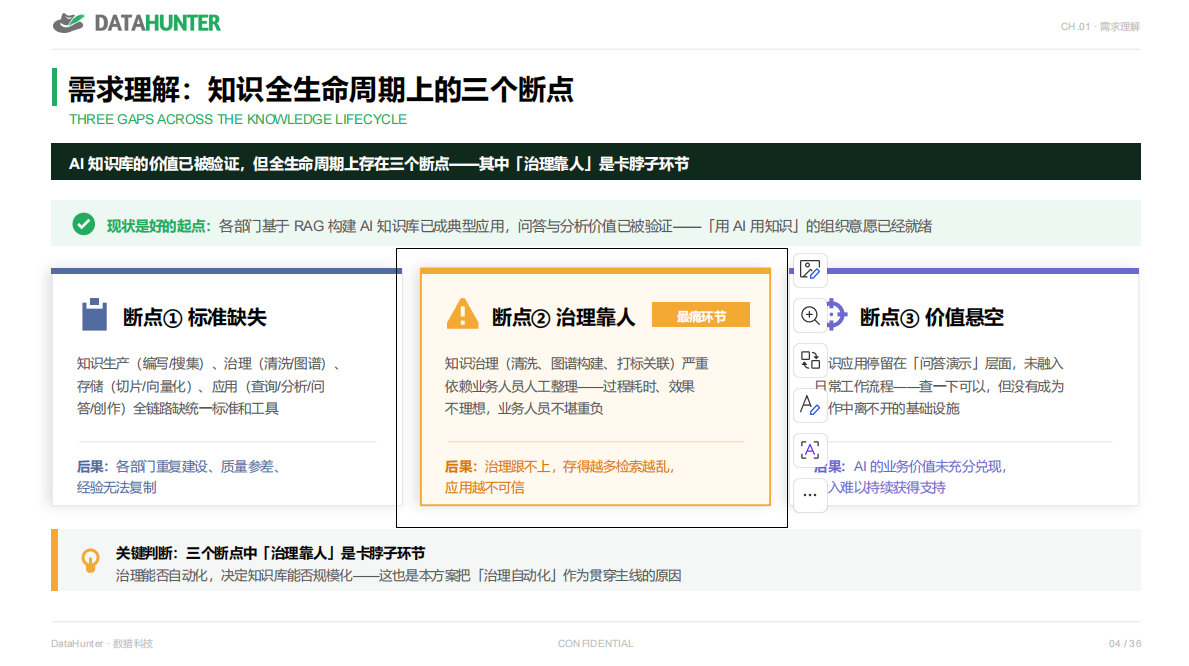
文档进去就进去了,答案出来就出来了。没有人负责判定哪一条是对的,没有人负责把过期的降下去,也没有人说得清一条错答案是从哪份文件、哪个版本、哪一句话开始错的。
更麻烦的是版本。同一份制度改过五版,五个版本都躺在库里,文件名一模一样。系统不知道哪一版有效,因为没有人告诉过它。它只能把五版全检索出来,再拼一个看起来合理的答案。
一条错答案从进库到被引用,中间没有任何一道关卡需要有人点头。
而且这一轮的 AI,比上一轮更难发现错误。
以前用关键词搜索,翻到原文就翻到了,翻不到就是翻不到,错得明明白白。现在它给你一段完整的结论,语气笃定,逻辑自洽,还附了三条看起来相关的出处。谁还会逐字去核。
答得越准,越没人核。危险就长在这里。
我们见过一家国有银行的信用卡中心,投了三百多万做智能知识库,上线之后闲置。不是钱不够,是从立项到验收,没有任何一个岗位上写着“对知识内容负责”。
而知识是会过期的。旧制度、失效参数、废弃方案,如果不退下去,会持续污染每一次检索和每一次回答。
没人签字的知识,不是知识,是传闻。
企业不怕 AI 答错,怕的是答错了追不到人。
五、人要在的位置,不是最后一道关
到这里,结论好像很明显了,多派人盯着就行。
这个答案之所以行不通,不是因为它不符合道理,是因为它不符合成本。
很多企业确实这么干了,配上知识管理员,每周抽检一批答案。很快发现两件事,一是抽不完,二是抽出来的问题改不动。一万份文档、几十万条知识条目,一个人一周抽一百条,抽完要几十年。等抽出来的时候,那条错东西已经被引用了上百次。
所以问题不是要不要人管,是人管在哪一环。
大模型能压掉的,是整理、检索、编译、回答这些动作。压不掉的只有一样,判断。
动作可以交给机器,判断不能。
人如果只在最后审答案,他一辈子都在重复同一件事。人如果把判断提前做成规矩,做一次就够了。
有一项对比研究做过测算,用专家定义的本体去引导抽取,比纯自动抽取,事实召回高出 55%,回答正确性高出 40%。人定下来的那点规矩,比算法多跑几遍管用得多。
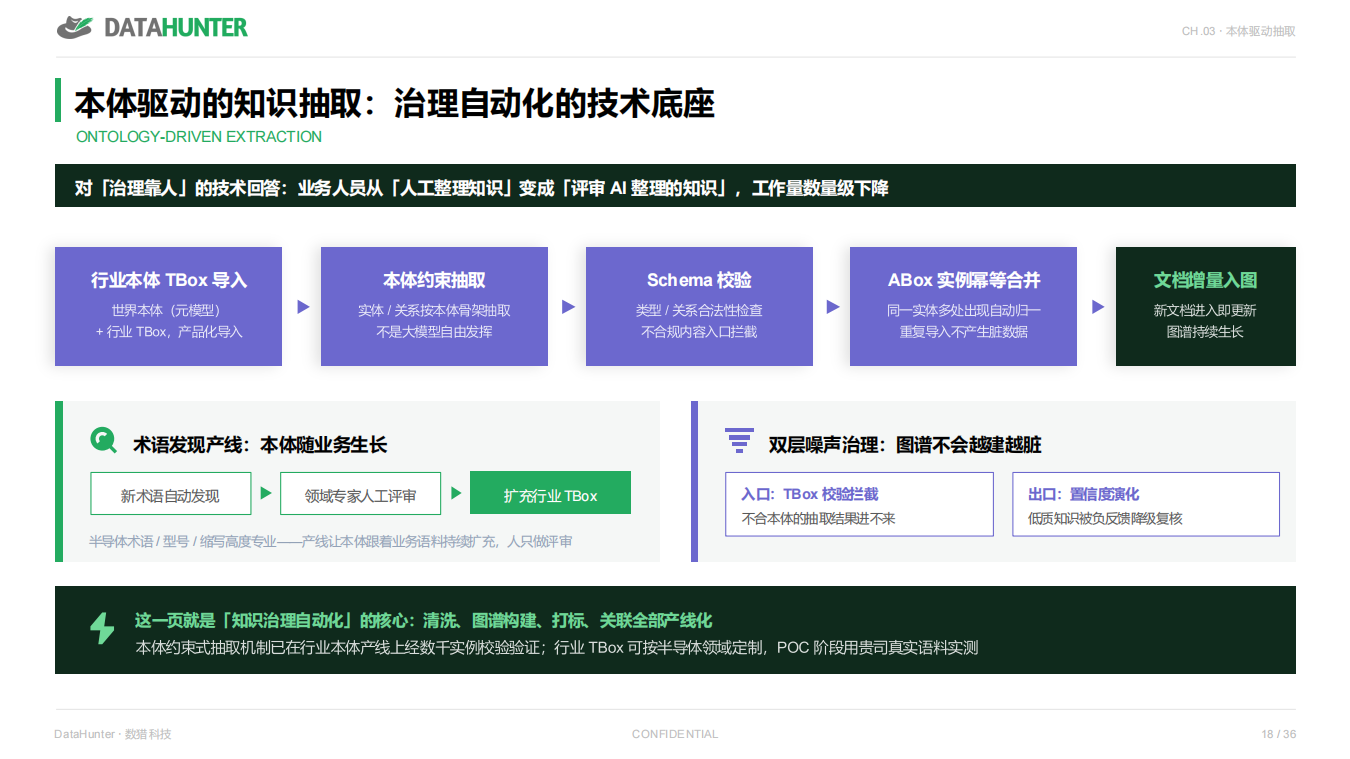
所以顺序要反过来。不是先让 AI 去抽,抽完再挑毛病,是先让人把规矩定下来,再让 AI 在这个框里干活。
规矩不是一句口号,是可以落成三条的具体动作。
第一条,先定名字。让业务专家一次性把领域里的核心对象定下来,设备、客户、工艺、产品,就这么多。之后 AI 抽出来的所有内容都要对齐到这份名单上。好处很直接,1号泵不会再变成三个东西。
第二条,限定关系。放任大模型自己编,“导致”“引起”“出现”其实是一个意思,图上散成一团乱麻,看着像图谱,实际是一堆巧合。把关系收成有限的几种,长尾的归到通用父类。好处是图能用了,问一台设备的故障,能顺着固定路径走到处置方案。
第三条,逐条核原文。抽出来的每一条关系,都回原文核对,找不到依据的挡在图外。我们内部跑的数,大约四分之一自动抽取的关系在原文里找不到依据。这个比例不算吓人,吓人的是没有这道校验的时候,它们全都进库了。
还有两件配套的事,缺一件这套东西就立不住。
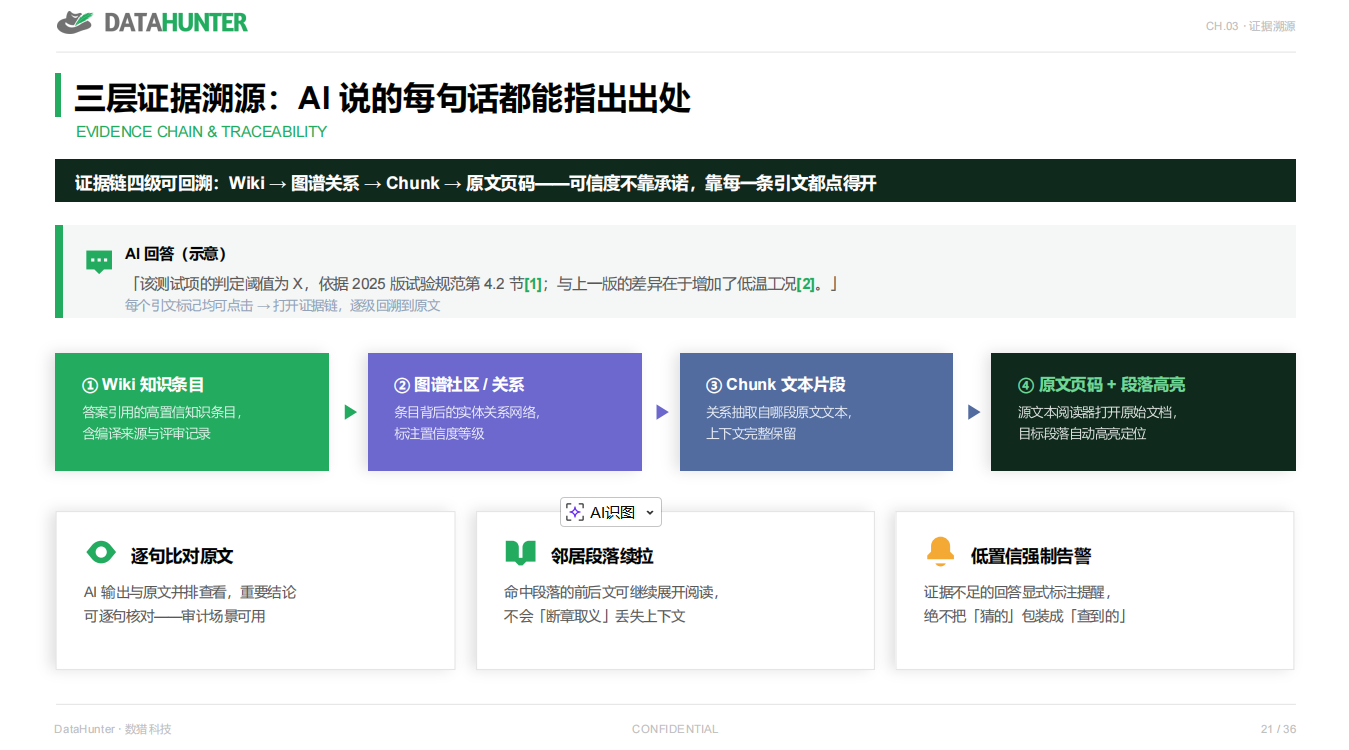
一件是溯源:每一条答案都要能点开,一路追到原文的哪一页哪一段。不是给个文档名了事,是能逐级回溯。没有这一条,签字的人不敢签。
另一件是退役:知识有有效期,过期的要自动降级、自动归档,而不是等人发现。低置信内容会被标出来,负反馈自动生成工单,派给对应的知识官复核关单。没有这一条,签过的字过半年就失效了。
前面那份把“1号泵”写成三个名字的文档,死就死在这一层。前面那条被引用三个月的废止版本,也死在这一层。
这套东西立住之后,是可以被量出来的。我们有一套系统在客户那边常年跑着,六千多用户,月活 90%。这个数字不是功能堆出来的,是员工问十次能对九次半,才会一直问。
AI 能替你整理一万份文档,替不了你说一句“这条不对”。
写在最后
企业买知识库的钱,越花越爽快。百万的系统,几个月的验证,报告写得漂漂亮亮。真正难的那部分从第 181 天才开始。谁来定什么算对,谁来决定哪条该撤,谁来为一条被引用的错答案负责。
整理的成本已经被 AI 打到了几乎为零。判断的成本,一分钱没降。
模型决定它能答多快,检索决定它能答多广。只有治理,决定它敢不敢让人照着做决定。
知识库里躺着的从来不是知识,是一家公司还没人认领的判断。
如果你也正卡在这一步,我们把这几年踩过的坑整理成了一份《企业知识库落地优先级清单》,里面拆了先做什么、后做什么、哪一步可以跳过:
扫描二维码即可免费领取