引言
这两年聊AI,话题永远绕不开模型参数、智能体、应用场景。
反观数据治理,声量确实越来越小。
好像大模型一来,定标准、洗数据、做台账这些事,就成了上个时代的遗产,没必要再提了。
甚至有句话很流行:“模型能力才是分水岭,数据治理都是细枝末节。”
听着很有道理,可真正扎进AI落地项目里就会发现:
绝大多数项目卡壳的地方,从来不是模型不够聪明。
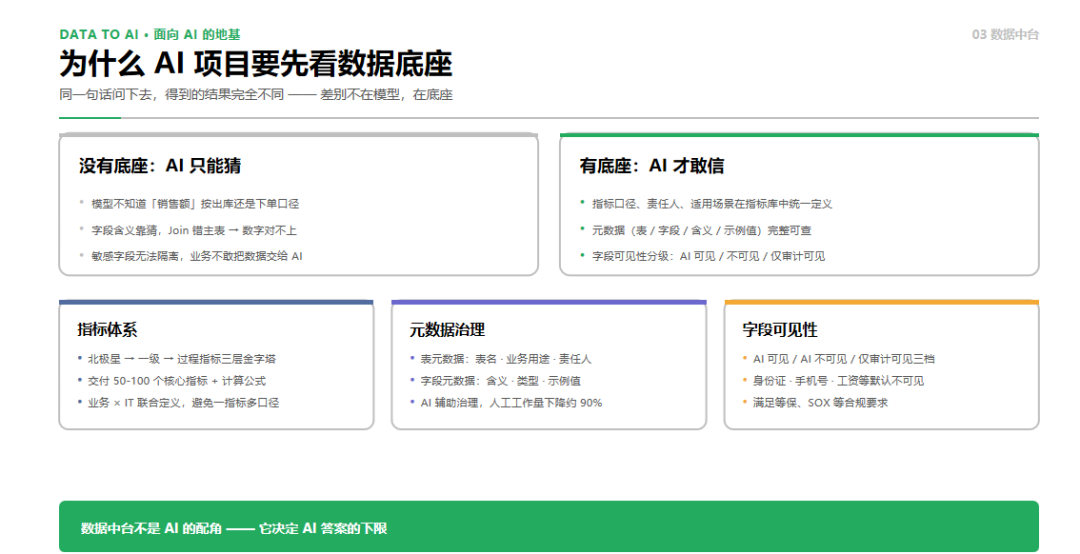
你问AI“本月新客转化怎么样”,它不知道“新客”按首登算还是按首购算,“转化”算转付费还是转活跃。
你要做跨渠道用户洞察,它拼不出一个人的完整轨迹——因为三条业务线里,同一个人有三套不同的ID。
出了问题复盘,结论永远高度统一:模型还不够强,换个更大的就好了。
但真相是:数据治理从来不是不重要了。它只是从报表后面的后台工作,变成了AI能不能落地的那条隐形底线。
今天DataHunter跟大家彻底聊透一个核心问题:为什么你的AI始终落不了地?数据治理,到底是怎么决定AI落地生死的?
如果你也正为 “基础数据混乱、数据没用起来” 发愁,我们帮您梳理一份《企业数据中台落地优先级清单》,点击下方链接即可领取:
内含 100+中小企业实操案例,结合你的业务场景,看看哪些数据该先治理、哪些AI项目该先绑定:从数据体检、标准搭建到质控闭环,一步步拆解 “先做什么、再做什么”,帮你避开 “盲目治理” 的坑,快速找准基础数据建设的起点,让每一分投入都能落地见效
扫描下方二维码立即免费领取
一、从前凑合用的数据,现在AI用不了
很多人没意识到最根本的变化:数据治理的服务对象,换了。
过去治理是服务人。人看报表、人做分析、人做决策。
人对数据是天生带“容错缓冲”的:数不对会质疑,口径模糊会追问,数据缺了会找数据部核对。哪怕治理做得马马虎虎,靠业务经验、靠行业常识,也能凑合用。
模型没有这个缓冲。
你喂给它什么,它就认为世界是什么。
口径错了,它不会觉得奇怪,只会按错的口径算到底,再给你一套逻辑自洽的结论。
数据缺了一块,它不会说“我不确定”,只会用手里仅有的信息,生成一个看起来完整的答案。
一句话:人看到数据会怀疑,模型看到数据只会执行。
过去口径不统一,最多是跨部门开会吵一架,谁声音大听谁的;
现在口径不统一,AI会把错的数字算得理所当然,你追问它怎么算的,它可能自己都说不清。
过去数据质量差,最多是报表被业务打回两句;
现在数据质量差,模型会一本正经地胡说八道,还贴心地给你配上分析结论和改进建议。
问题从来不是模型不够聪明。
是数据本身带着病,而模型会把这个病,原封不动地放大给整个公司看。
二、数据治理不是没价值了,是功劳看不见了
一项工作什么时候会被组织觉得“不重要”?
不是它没价值的时候。
是它的价值没人看得见的时候。
以前数据治理的存在感很强:质量分从60涨到95,报表准了,口径统一了,跨部门吵架少了。这些成绩看得见、说得清、写得进汇报。
现在不一样了。
数据治理的成果,全藏进了模型的输出里。
模型答得准,那是大模型的功劳,是算法团队的成果,是AI战略的胜利。
模型答错了,那是模型不行,是参数不够大,等下一代就好了。
治理在哪儿?
它没出现在任何一份功劳簿上,也没出现在任何一次事故复盘里。
它成了整条链上最尴尬的角色:干得好没人知道,干得差也没人怪它——因为大家压根没往那个方向想。
所以“数据治理不重要了”从来不是一个技术判断,是一个组织认知的错位。
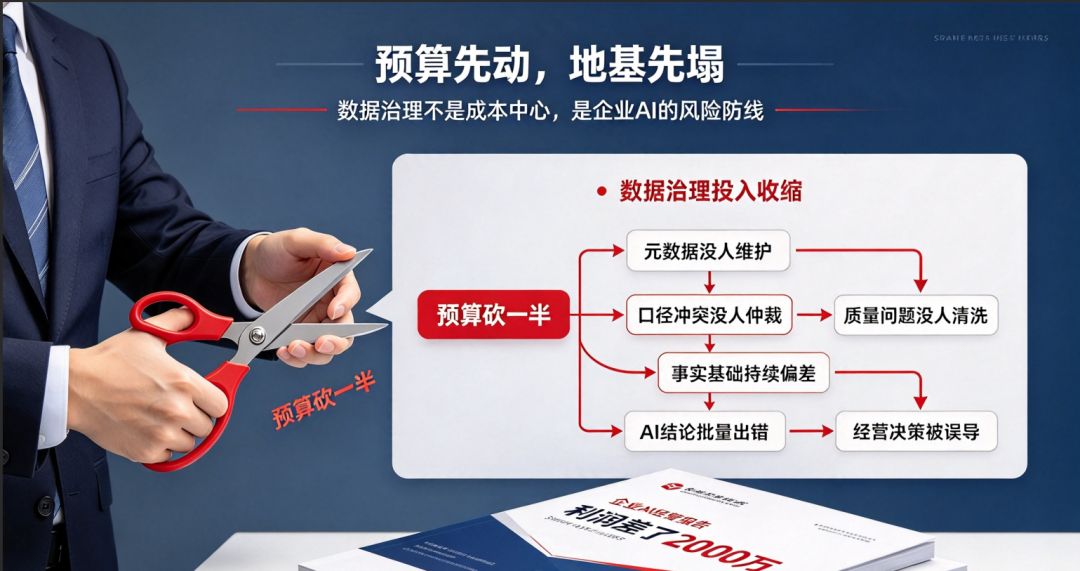
一件事的可见度没了,投入就会跟着缩水。预算要砍的时候,先砍看不见的活;编制要减的时候,先减说不清价值的岗。
可账不会因为看不见就不用还。
模型每输出一个错的数字,每给出一次跑偏的建议,都是在替数据治理的欠账买单。
只不过这张账单,最后都签在了AI团队的名字上。
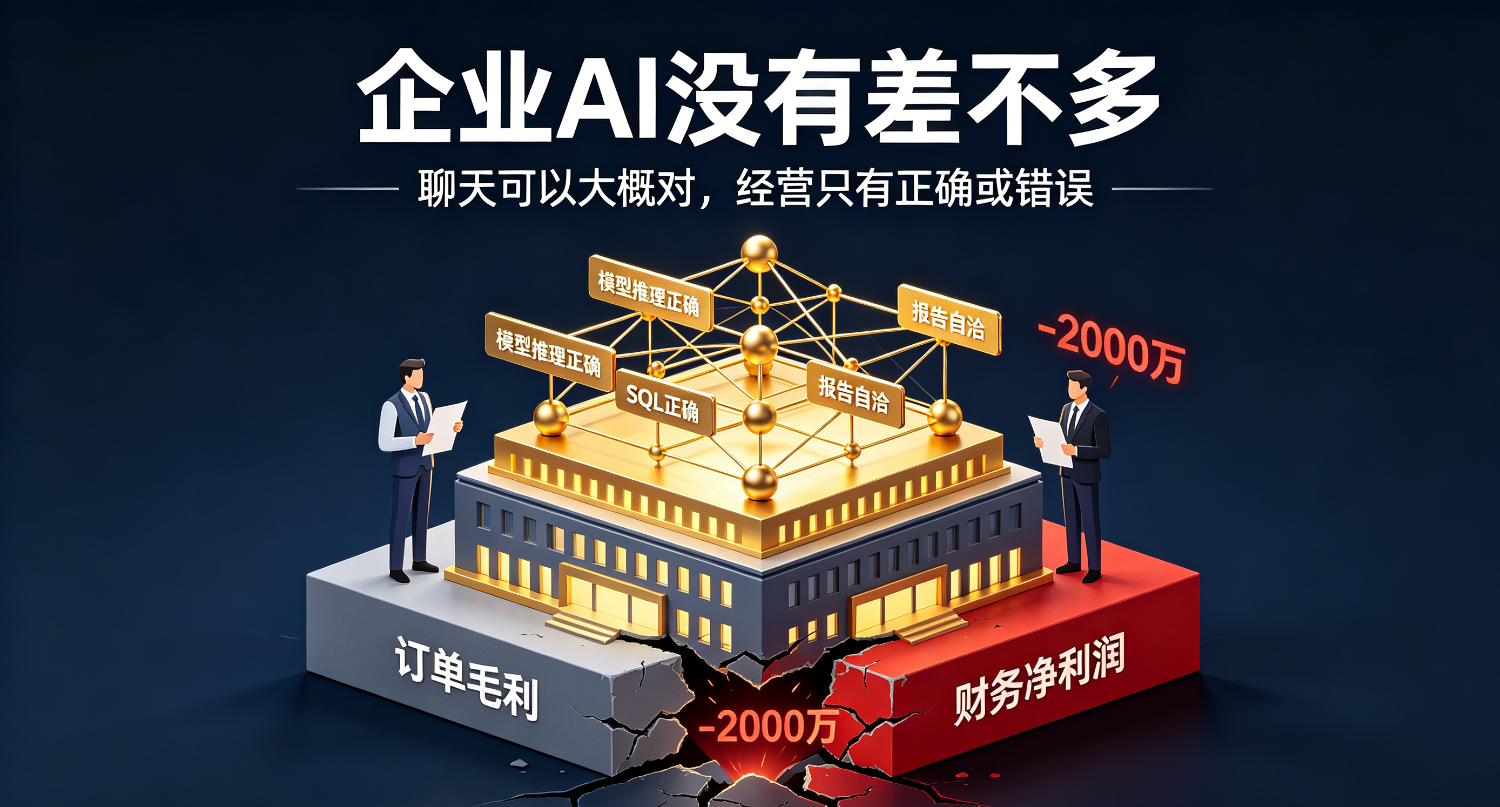
三、AI不是来解决治理的,是来催债的
总有人说:AI都这么强了,让它自己去治理数据不就行了?
这话只对了一半。
AI确实能帮我们干很多治理的活,但它首先做的第一件事,是把治理的欠账,全翻到了台面上。
过去在后台靠人工悄悄消化掉的问题,现在全都涌到了前台。
第一类,过去能糊弄的,现在糊弄不过去了。
标准字段不统一,过去靠数据工程师在中间人工翻译一下,报表出来照样能用。现在用户直接对着系统提问,中间没人兜底,每一次定义的偏差,都会变成一次答案错误。
第二类,过去没人查的,现在被逐个点名。
训练数据样本单一、场景片面、分布不均,这些问题在报表时代根本不会被发现——毕竟报表只看几行汇总。但模型不一样,它会把数据里的每一种偏差都学进去,然后在真实业务里精准复现。
第三类,过去是麻烦的,现在是风险。
权限粒度粗、敏感数据边界不清,过去最多是审批多走两步,没人当回事。现在智能体跨系统调数,一次越权取数,可能就是一次合规事件。
这三类问题,AI一个都没自动解决,它只是让这些问题再也藏不住了。
更棘手的是,数据量本身也在爆炸。
过去企业治理的是几十张核心表、几百个字段,一个团队咬咬牙能啃下来。
现在多模态、行为日志、实时流数据一起涌进来,靠人工巡检、定期复盘、批量整改这套打法,根本跟不上模型迭代的速度。
不是不想治,是靠人治不过来了。
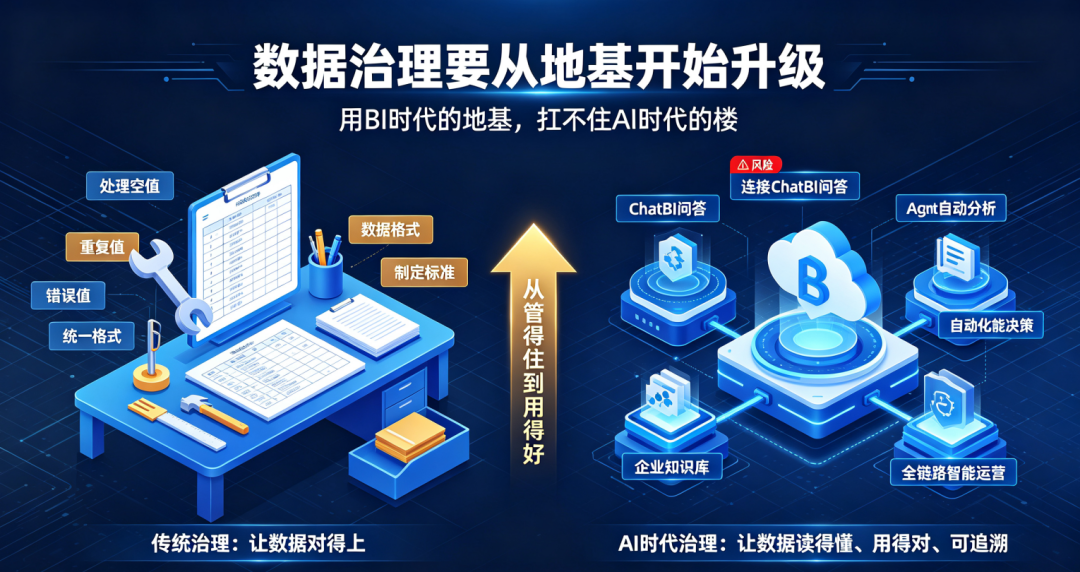
四、如何破局?把治理嵌进数据流转的每一环
说到这里,很容易走到另一个极端:既然传统治理跟不上了,那就推倒重来,做一套AI原生的治理。
这是我们DataHunter最不认同的做法。
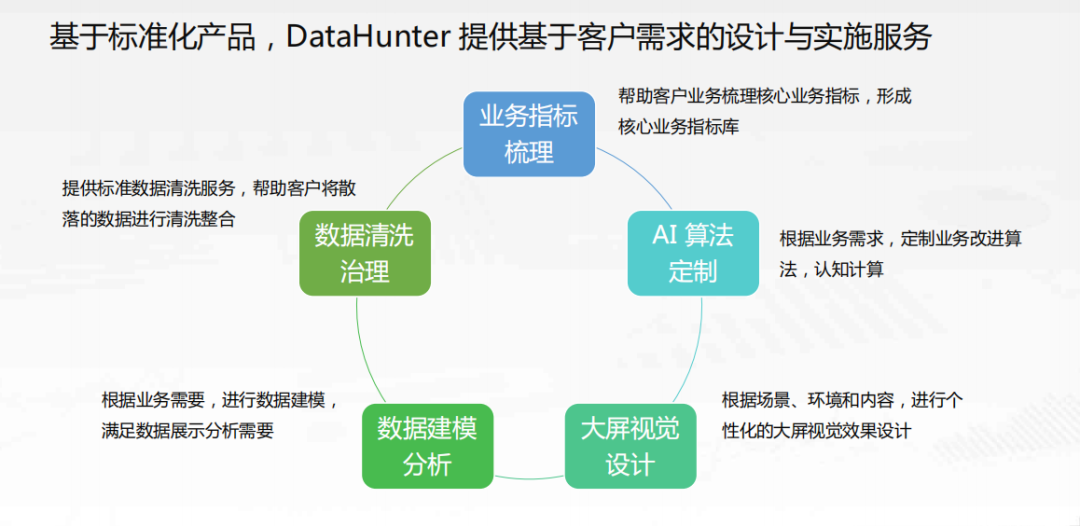
服务过上千家企业,我们见过太多推倒重来的项目,最后无一例外都变成了重复投入。
原因很简单:传统治理沉淀下来的元数据、数据标准、质量规则、主数据体系,从来不是包袱,是地基。
地基没打好,上面盖什么都塌;地基打好了,上面加什么都能用。
正确的思路从来不是推翻重建,而是利旧升级。
不是把已有的治理成果扔掉、重新买一套AI产品,而是在已经打好的地基上,长出一层AI能力。
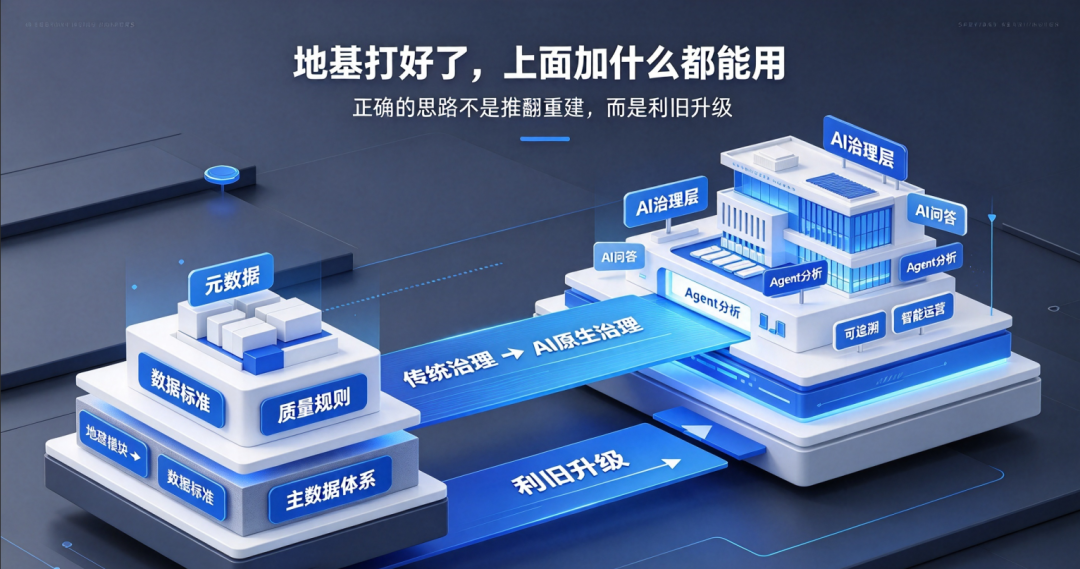
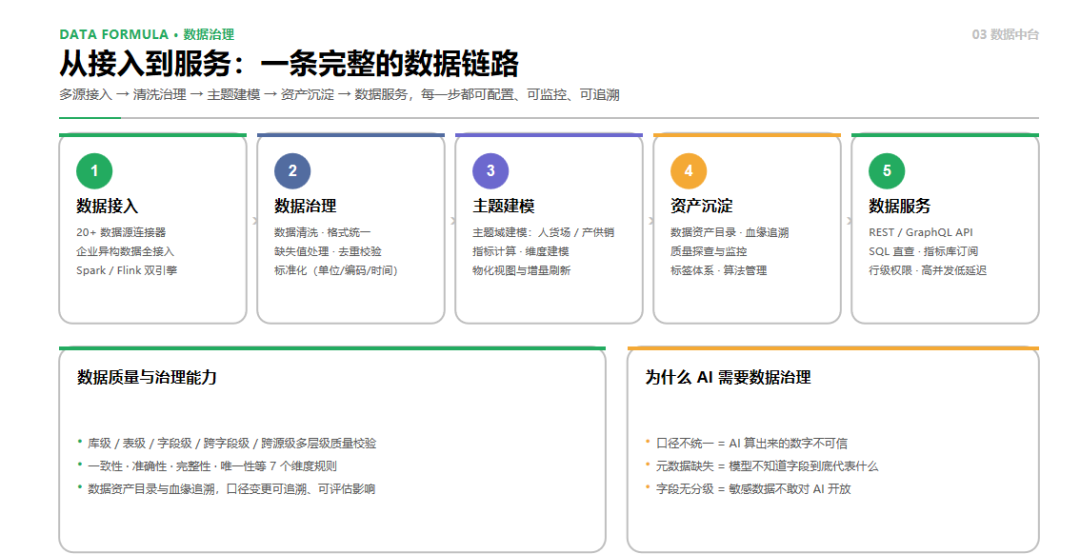
这也是我们做 DataFormula 从一开始就坚持的逻辑:它从来不是一个跟传统治理割裂的新工具,而是同一套体系里的两层能力。
传统治理该有的元数据、数据标准、质量、主数据、血缘、信创适配,一样不落;同时把AI能力做进治理本身,而不是在旁边挂一个AI插件。
企业已经定的标准、已经配的规则、已经理的指标,不需要迁移、不需要重来,直接就能跑。
毕竟绝大多数企业不是没做过治理,是已经治过一轮了,再也经不起第二次从零开始。
而AI时代的治理升级,核心就是三件事:
第一件,让治理的活少靠人堆。
把人工反复做的事交给模型和智能体:自动解析字段语义、推荐标准映射、按业务场景生成质检规则、发现异常并定位根因。
不是给平台加个AI按钮,是让治理能力本身长在AI上。
原来一个数据团队三周才能磨出来的标准草案,现在几天就能成型。省下来的不只是时间,是让治理这笔投入,第一次算得过来。
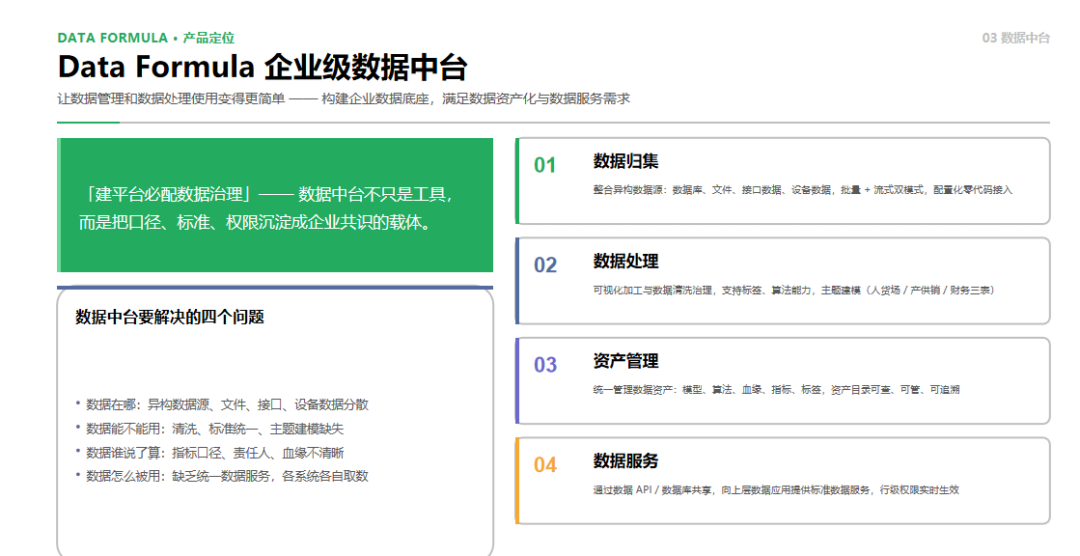
第二件,让AI说得出数从哪来。
这是AI能不能用在正式经营场景的关键。
从用户提问到需求解析、指标匹配、到最终取数,每一步都要有记录、有来源。AI给出的结论,能顺着计算逻辑往回查:经过了哪些加工、取自哪张表、用的哪个口径。
不是“AI算的,我们也不清楚”,而是每一句话都能对得上账。
第三件,让业务自己用得起来。
治理成果如果只握在数据团队手里,永远只是一份报告。
把它封装成业务随手能用的东西:用日常语言直接问数,不用写SQL、不用排队等排期;关键指标异常自动推送到人;决策执行之后效果自动回流,形成闭环。
业务能直接从治理里拿到好处,治理才有人愿意一直推下去。
当数据不再需要专门去查,而是融入日常决策,治理的价值才算真正落了地。
五、写在最后
大模型走到今天,参数、窗口、技术框架都不再是壁垒。通用模型可以开源,算力可以采购,Agent 方案可以抄作业,真正难复制的,从来不是上层的模型能力,而是底层的数据底子。
数据口径是不是统一?
结论是不是可信可追溯?
业务含义是不是能被AI准确读懂?
这些问题,没有一个靠换模型能解决,只能靠数据治理一点点夯出来。
AI 从来不会帮你补上数据的烂账,它只会把你藏在底层的问题,更快、更广地摊在所有人面前。
企业 AI 的终局之战,拼的从来不是谁的模型更贵,而是谁的数据更稳。
如果你也遇到“数据很多,用不上”的问题,现在扫描下方二维码免费领取
《数据中台落地方案》,含生产排产、库存优化、精准营销、智能风控等实操模板