这几年做数据治理的企业,像赶一场集体作业:中台建了,咨询请了,几百页的标准文档也评审归档了。
可实际结果呢?
年初对齐的客户口径,年底对账还要开三次协调会;去年刚清完的供应商脏数据,今年报表里又原样冒出来;中台上线两年,业务岗还是自己拉 Excel 凑数做报表。
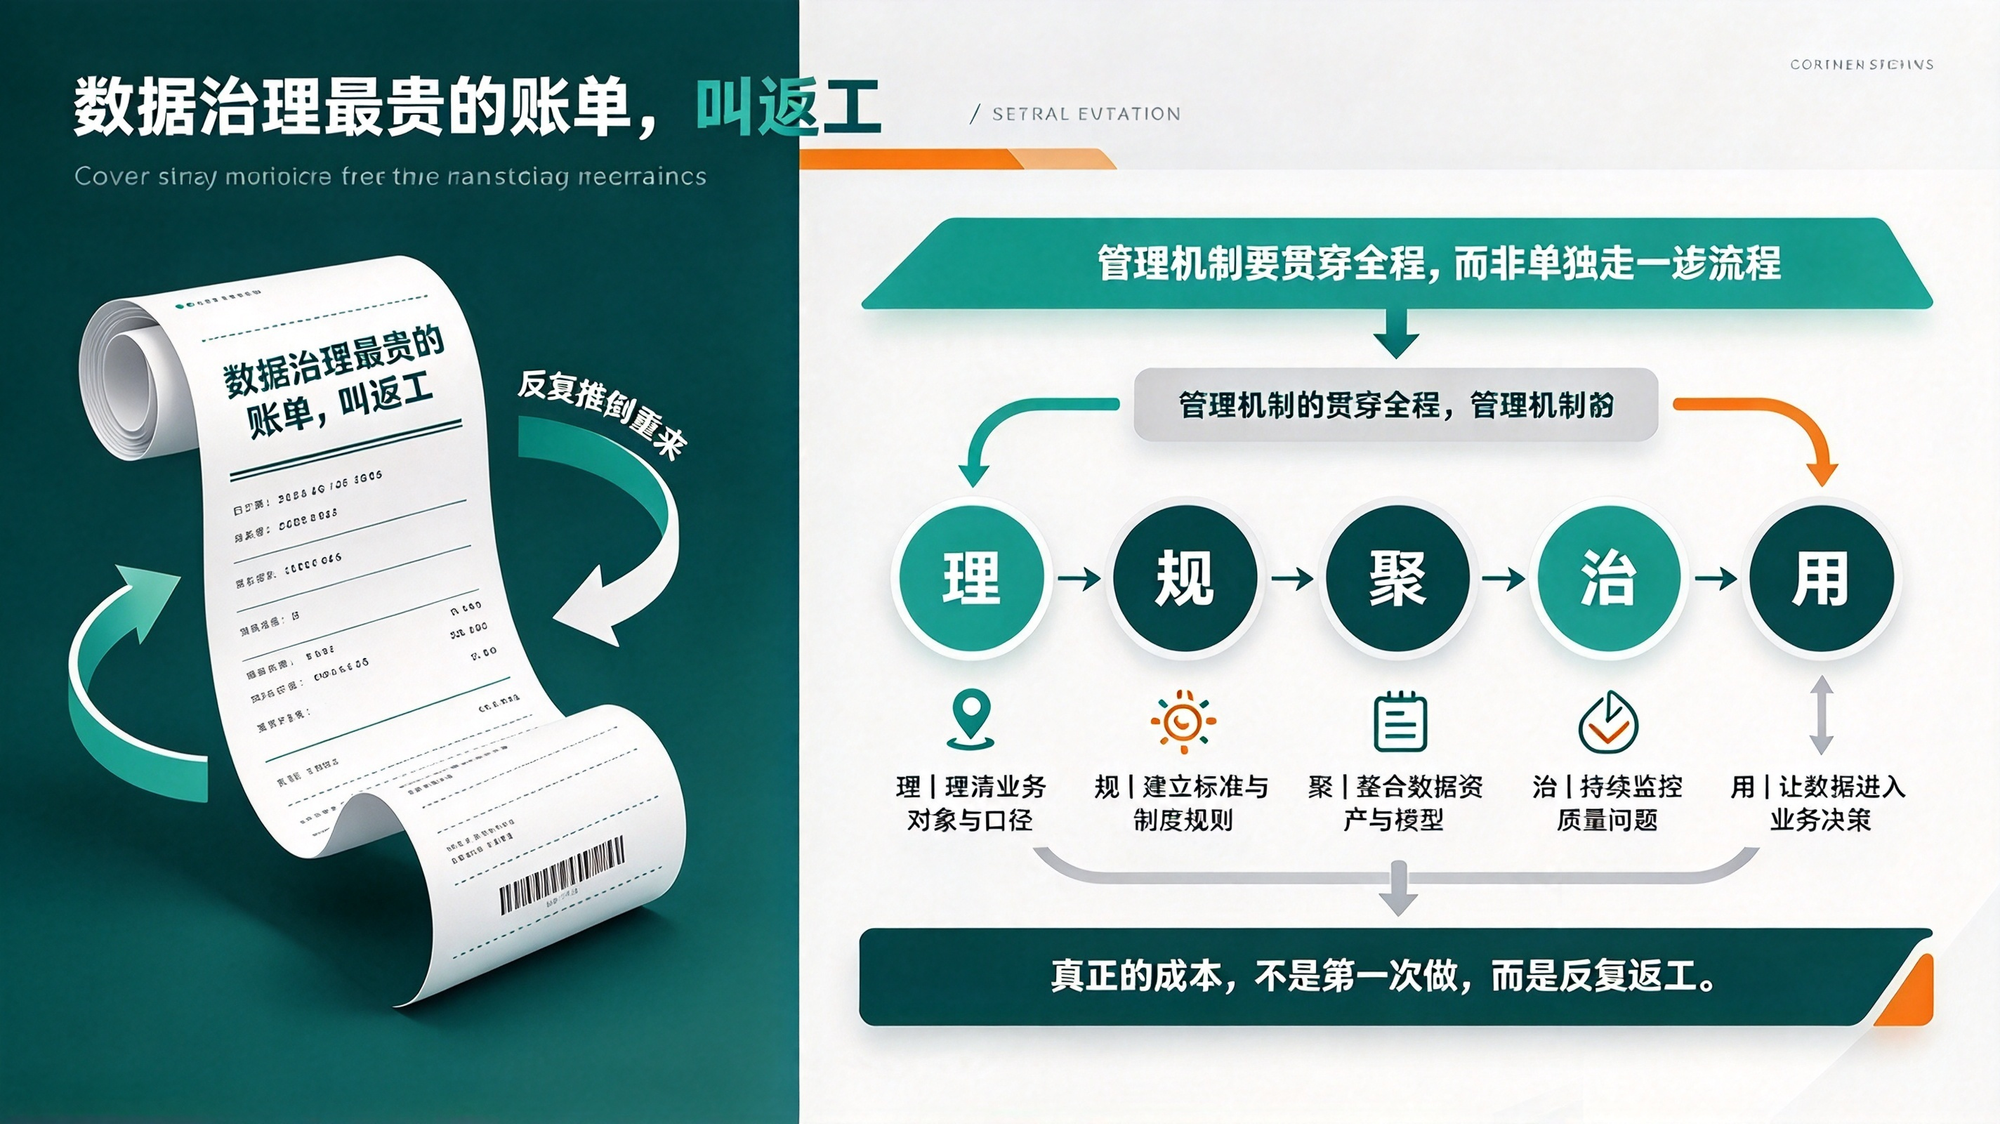
大家普遍把问题归为工具不行、团队不专业、数据太脏。但 DataHunter 见过上百个项目的生死,只想说句真话:数据治理最贵的成本,从来不是工作量,是返工。
一家企业做三年治理,最疼的不是投了多少人月,是同一件事反复做三遍:盘完家底建仓,才发现业务对象都说不清;定完标准上线,才发现只剩文档在生效;清完脏数据收尾,第二年错误又原样复发。
每一次返工都在消耗成本,只是当时没人认领这笔账。
数据治理的核心动作,说到底就是「理、规、聚、治、用」五步,而管理机制要贯穿全程,而非单独走一遍流程。
下面不讲空泛的方法论,只说每一步最容易踩的返工坑,以及怎么靠落地管理躲开。
如果你正为 “治理做了几遍还在原地” 发愁,我们整理了一份《数据治理返工自查清单》,把全流程核心检查点浓缩成一页,文末可免费领取。
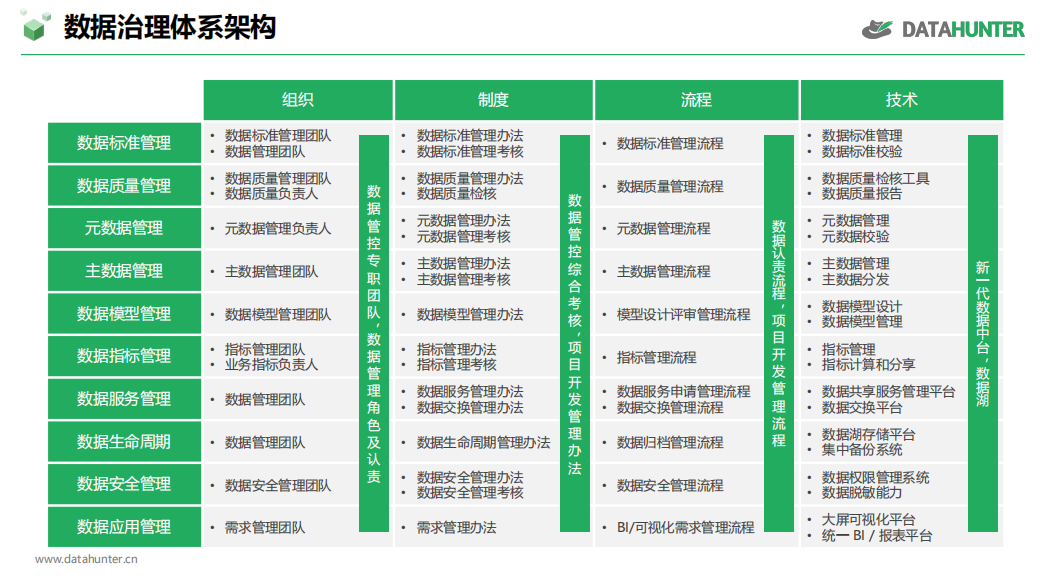
理:盘点家底:别光数有多少张表,先搞清楚谁来担责
多数企业做数据盘点,都从系统入手:统计有多少套系统、多少张表、多少个字段,最后输出一份几百页的资源清单,锁进共享盘就完事。
这份清单能回答 “数据在哪里”,却回答不了 “出了错找谁”—— 数据不是找不到,是说不清从哪来、经过谁的手、服务哪张报表,脉络完全是糊的。
真正有效的盘点,必须分三层,且顺序不能乱:
1. 先理组织:明确谁管对应业务、谁对数据结果负责;
2. 再理业务:梳理核心业务流程、关键事项和业务对象;
3. 最后理数据:对应业务过程,匹配系统、数据表和字段,建立业务与数据的映射。
先梳业务,才知道该捞什么数据;先定责任,清单才不是一堆无主的表名。
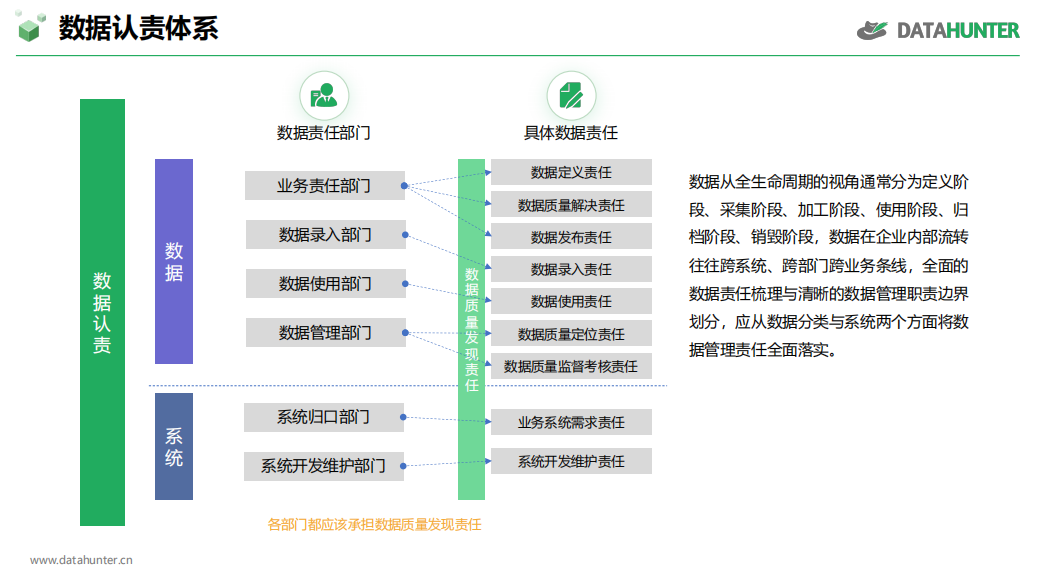
比如某省级银行把数据责任拆成定义、录入、使用、质量定位等 7 类,对应不同主体,核心就是让定口径的人不能自己判对错。
盘点也不用追求全量,优先抓二三十个核心数据项就够。
筛选就看两个维度:
一是重要性:高层是否关注、是否多部门共享、有没有被监管通报过;
二是可行性:有没有现成标准、有没有明确责任方、改造成本高不高。
优先做 “既重要又好落地” 的部分,剩下的留到后续迭代。
一句话自检:随便挑一个核心指标,能不能说清谁定义、谁录入、谁发布、出了错谁负责?说不出来,这个数据就还是 “孤儿”。
落到工具上,靠人工登记血缘永远跟不上模型变更,最优解是把业务元数据与技术元数据统一管理,自动拉通全链路血缘 —— 这也是 Data Formula 的核心能力之一,每个数据集都能清晰查到来处、去向和责任主体,省掉大量人工维护的返工。
规:定标准:别闭门写厚文档,要把业务分歧捋顺
很多项目的返工隐患,从定标准这一步就埋下了。
最常见的误区:闭门写几百上千行技术标准,装订归档就算完成;甚至先建模型再补标准 —— 等要改的时候,改程序要排期、要停机、要沟通,最后让步的永远是标准。
标准难的从来不是写定义,是解决分歧。
真正让业务拍桌子、让报表对不上的,从来不是字段长度、数据类型,而是两件事:一个词到底指什么(术语),一个数到底怎么算(指标口径)。
这两样编不出来,只能从不同部门的分歧里 “收” 出来。
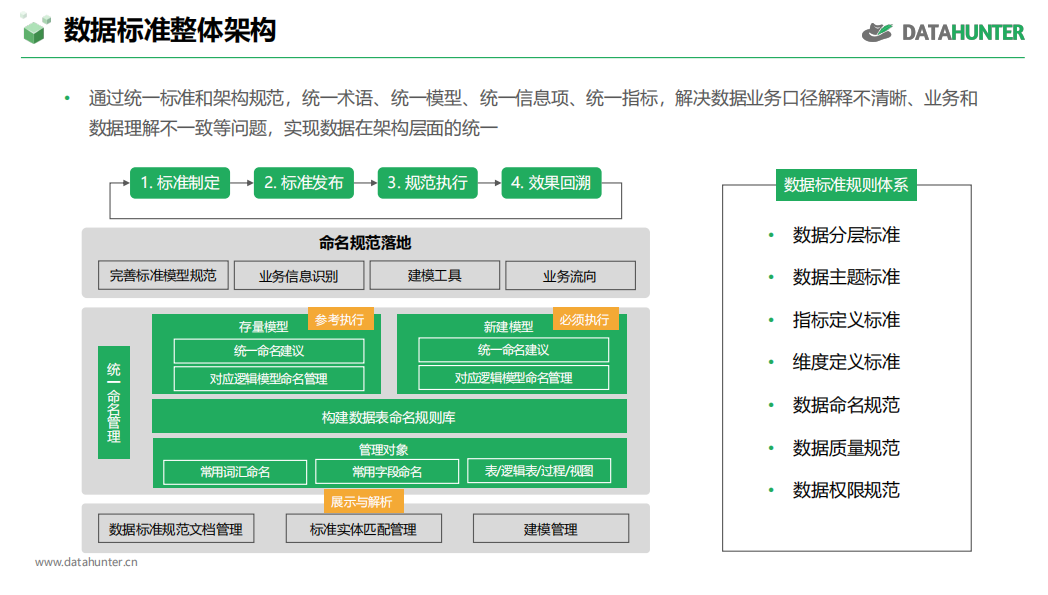
数据标准分五类:术语、指标口径、数据元、代码表、主数据标准。
优先级永远是业务类在前,技术类在后 —— 先统一术语和口径,再定技术规范,顺序反了大概率要推倒重来。
落地抓三个原则,能躲开 90% 的无效标准:
第一,不铺全量。只选 “多部门共用、曾引发争议、影响核心报表” 的对象,一般二三十个就够。
第二,收口径不编定义。
拉通业务与技术对齐差异:叫法不同就统一命名,范围不同由业务拍板,时点不同定基准、写清例外。第三,做最小可用标准。
不用几十列的冗余文档,一个对象一行,写清五件事就够:业务定义、计算口径、类型与值域、编码规则、责任人。
写不出 “含不含税、算不算退货、按哪个日期”,这条标准就等于没写。
标准定完不算完,必须卡进开发全流程才算落地:需求提出时比对标准字典,概要设计时做模型映射,开发时按规范实现,测试时按标准复核,上线前再做最终评审。
五个卡点缺一个,标准就会退回纸面,迟早要返工。
一句话自检:一条标准写出来,业务能不能一眼看懂,执行时没有第二种理解?
聚:汇聚数据:别光搬数进仓,要分层守好边界
理清楚、定好标准,下一步就是数据汇聚。这一步最常见的返工坑,是把 “接进来了” 当成 “聚好了”。
所有源系统都接进数仓,可同一个客户三个编码、同一笔金额一个含税一个不含税、同一个供应商三个名字,接完还是没法用。
搬运只解决了通道问题,没解决 “说法统一” 的问题。
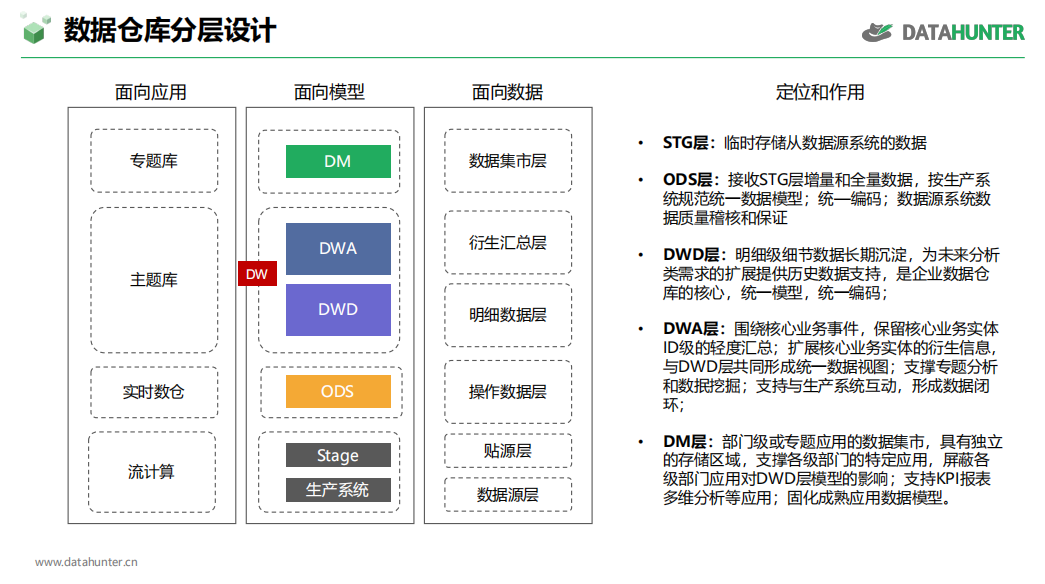
汇聚的核心是分层,每层只干一件事,边界绝对不能糊:
层级 | 核心职责 | 绝对不能做 |
贴源层 ODS | 原样留存原始数据,保障可回溯 | 不清洗、不关联、不改字段名 |
明细层 DWD | 统一明细口径,同一件事只有一种说法 | 不做跨主题汇总 |
汇总层 DWS | 指标口径只在这里定义一次 | 不为单张报表单独定制 |
应用层 ADS | 只做展示类加工(排序、格式、权限) | 不修改指标口径 |
多数企业的数仓不是层太少,是每层都在干所有事:贴源层做了清洗,原始数据追不回来;明细层写了业务口径,换部门就对不上;应用层改了计算逻辑,同一指标多出好几个版本。
建设也不要一层层平推,挑一条业务主线(比如采购到付款),从源表到报表贯通一次,再复制推广。
落地有三件事不能省:统一主数据编码、拆分不同时间字段、脏数据处理留痕。
一句话自检:随便挑一笔业务,能不能从应用层一路追回贴源层?追不回去的报表,就是黑盒。
接进来的只是数据,能对上、可追溯,才叫资产。
治:质量治理:别只救火清数据,要堵上出错的口子
数据汇聚完,就到了质量治理。这一步最容易陷入 “救火式治理”:发现一批错数据,拉业务集中清一遍,报表对上就完事。
但被清掉的只是错误,不是产生错误的口子。录入规则没改、系统校验没加、上游逻辑没动,清多少次错误都会再长回来。
治理的核心不是 “纠正”,是 “找根因、堵口子”。
数据质量问题通常来自三个渠道:业务投诉(最真实,一定已经影响了实际工作)、规则监控(成本最低,从事后救火变事前预警)、对账差异(最省事,和财务、上游系统对账就能发现问题)。
发现问题后,根因往回问三层就够:
1. 谁录的?手工填写、系统带出,还是接口传输?
2. 录的时候有没有校验?必填、格式、值域、跨字段校验有没有做?
3. 为什么没拦住?规则没写、规则太松,还是告警没人处理?
三种根因对应三种整改:补规则、收紧规则、给告警找具体接收人。很多整改没效果,就是把三种问题混成了一句空话 ——“加强管理”。
比如某省级银行落地千余条质量规则后,数据问题事前发现率提升 60%,业务端质量投诉下降近一半。
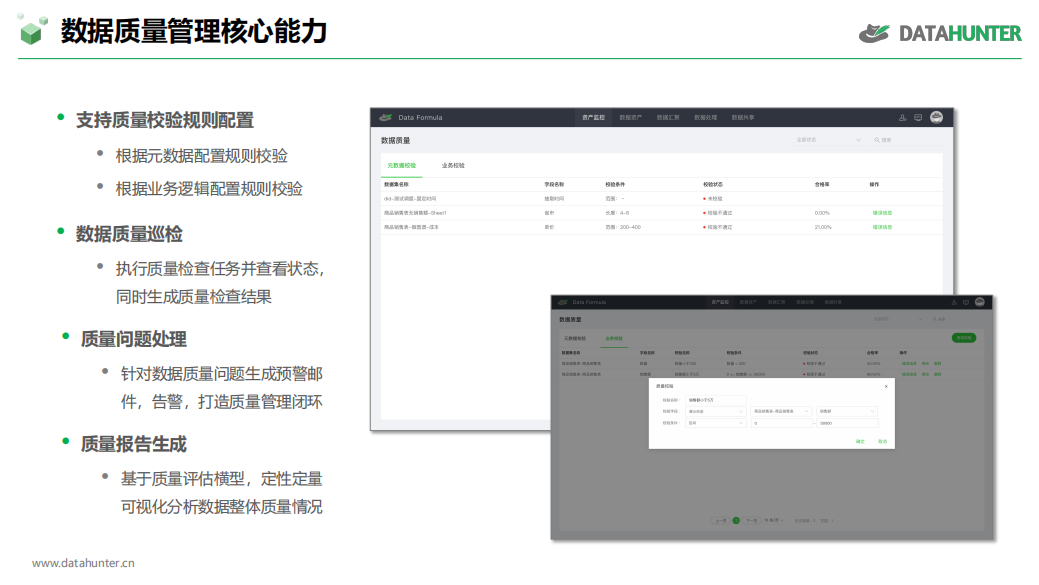
规则不在多,关键是要写得能落地:检查对象、逻辑、频率、阈值分级、责任人,五样缺一不可。
存量清理也要守四个原则:分批处理、全程留痕、脚本执行、对账校验。其中留痕最容易被忽略,也最关键 —— 半年后审计问询、业务问差异,都要有据可查。
要从根源防复发,就得让质量规则从标准里自动生成:标准定完,校验规则同步落地;标准一改,规则同步更新。
Data Formula 把标准与质量校验放在同一条链路,省掉了 “二次翻译” 的返工成本;再把复发率纳入月度考核,才算真正把管理闭环跑通。
一句话自检:整改完的问题,会不会原样重复出现?
数据质量做不到零问题。
合理的目标是问题不重复,而非达标率 100%—— 后者做不到,最后只会变成没人当真的口号。
用:落地使用:别建门户等人来,要嵌进日常工作里
前面四步做得再标准,没人用就全是无效工作量。最常见的翻车做法:建一个漂亮的数据门户,发通知让业务来用。
但业务不会来 —— 他们有自己的报表、自己的会议、自己的工作习惯。
有效的做法反过来:找到业务已经在用的东西,把治理后的数据换进去。会照开,表换个数据来源;报表照发,数换个统一口径。
业务感觉不到你建了什么,只感觉到这次的数对了。
选落地场景,就看三个标准,三个都满足再动手:
第一,有人疼。出了错有人被问责,没有问责人的场景推不动。
第二,有基础。主要数据已经在系统里存在,全靠新建等不到见效那天。
第三,见效快。三个月内能看到明确的指标变化,而非 “体系建成” 这种空话。
满足条件的场景不止一个,就挑最痛、最容易落地的先做。
用起来之后,一定要做好记录:谁用了、问了什么、哪里对不上、最后怎么解决的。
这份记录比任何满意度调查都准 —— 它不是评价,是真实需求,就是下一轮治理的输入。治理的闭环,就在这里合上。
一句话自检:治理后的数据,有没有嵌进业务每天必看的报表、每周必开的会?
写在最后
理、规、聚、治、用,连起来不是一条直线,是一个循环。管理不是单独的一步,是嵌在每一个环节里的保障机制。
第一次的 “用” 是选场景定方向,第二次的 “用” 是验证效果、输出新需求。循环转起来,每一轮都会比上一轮更轻、更快。
顺序反了会怎样?
不盘点就建仓,建完发现对象都说不清;不定标准就汇聚,接完还是三套口径;只清数据不堵源头,年年清年年有;标准不进流程,一年后全部退回纸面;把使用放最后,前面全成了没人验证的工作量。
这些最后都会汇成同一笔账:返工。
返工本质上不是执行力的账单,是责任的账单 —— 没人对数据签字负责,就会一直长出第二个版本。
最后给一个最低成本的行动建议:不用急着推翻现有体系,也不用追求一步到位。
先挑一个争议最多、影响最广的核心指标,把它的业务定义、责任人和追溯链路理清楚,堵上第一个出错的口子 —— 你就已经躲开了 80% 的返工。
我们把全流程的返工风险点,整理成了《数据治理返工自查清单》,涵盖每个环节的核心校验标准和常见踩坑点,扫描二维码即可免费领取