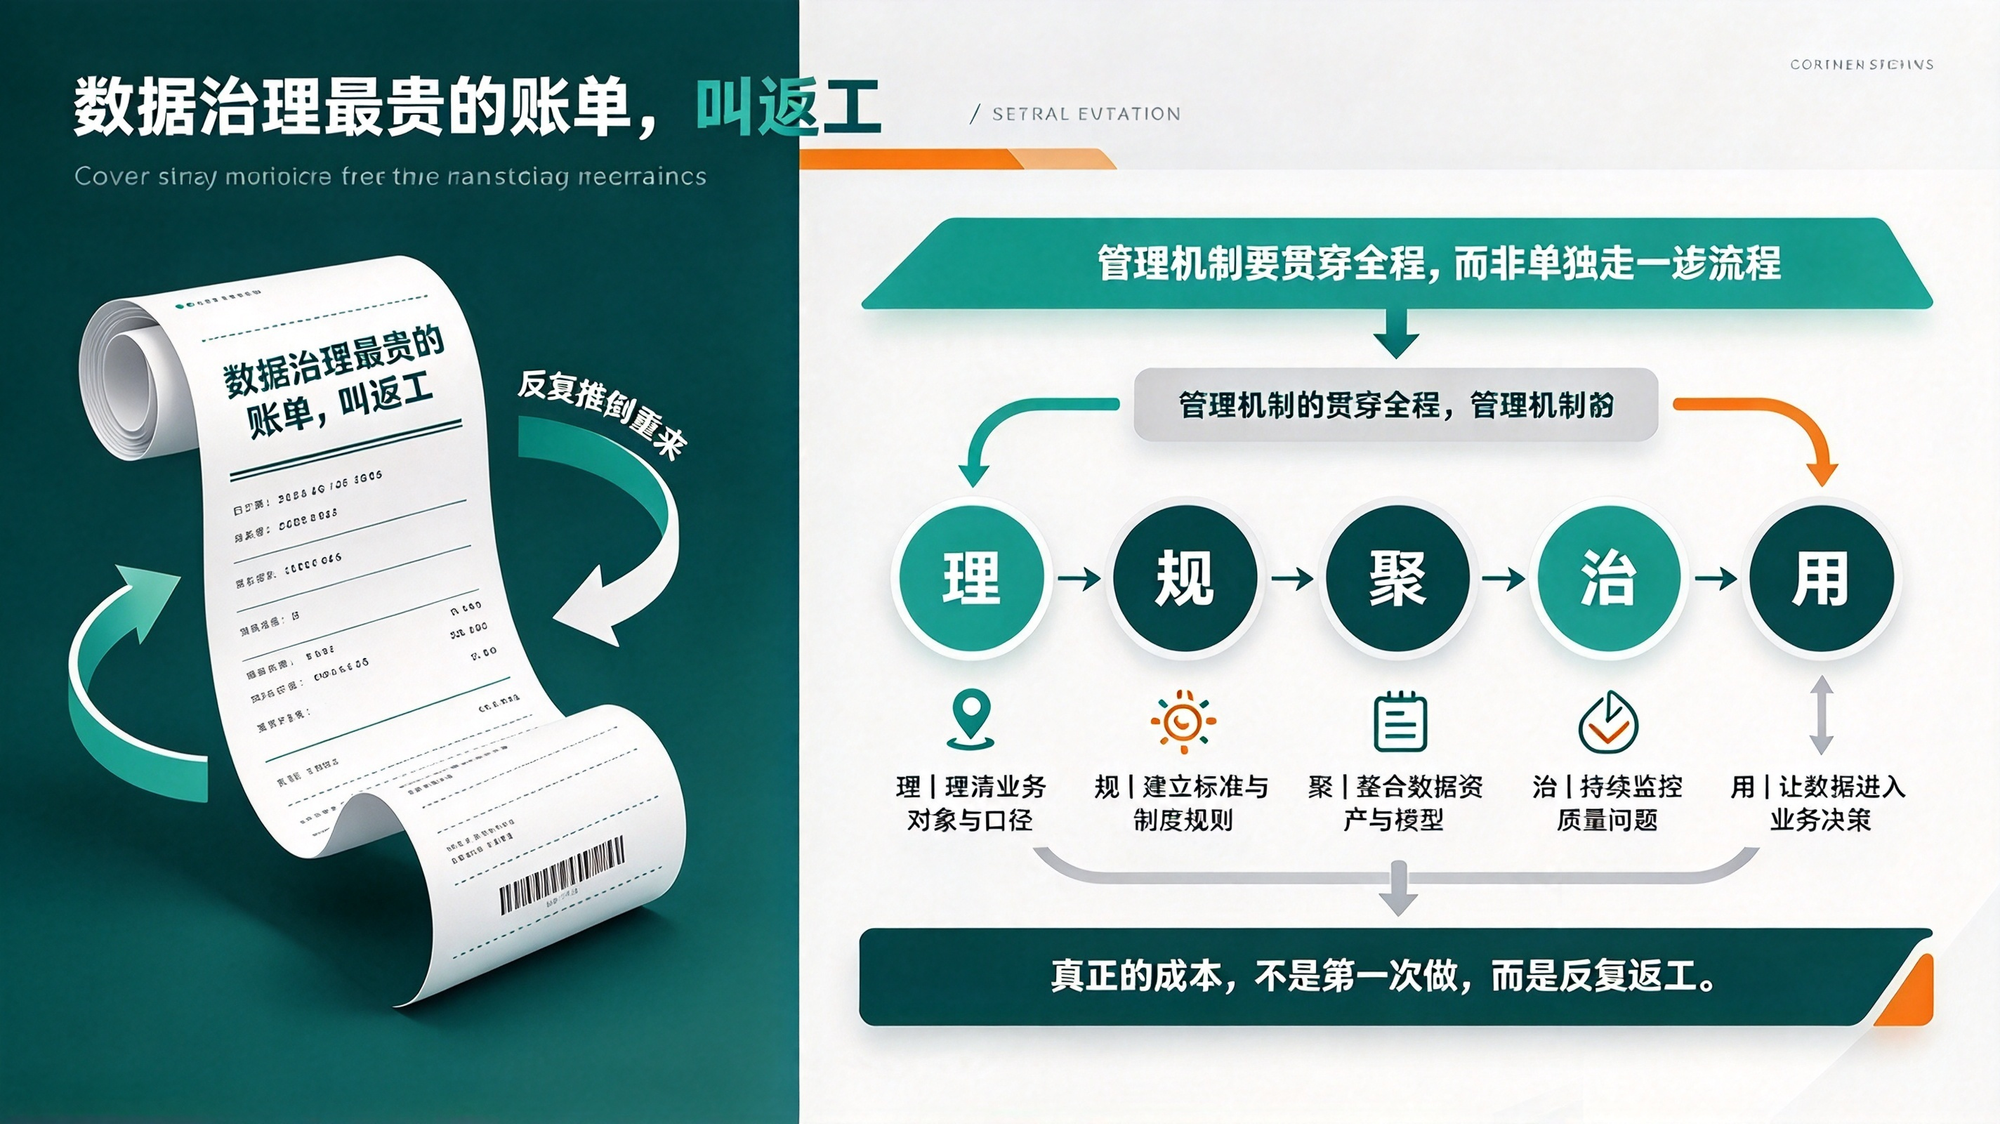
数据治理最烧钱的,从来不是干活,是返工
这几年做数据治理的企业,像赶一场集体作业:中台建了,咨询请了,几百页的标准文档也评审归档了。 可实际结果呢? 年初对齐的客户口径,年底对账还要开三次协调会;去年刚清完的供应商脏数据,今年报表里又原样冒出来;中台上线两年,业务岗还是自己拉 Excel 凑数做报表。 大家普遍把问题归为工具不行、团队不专业、数据太脏。但 DataHunter 见过上百个项目的生死,只想说句真话:数据治理最贵的成本,从来不是工作量,是返工。 一家企业做三年治理,最疼的不是投了多少人月,是同一件事反复做三遍:盘完家底建仓,才发现业务对象都说不清;定完标准上线,才发现只剩文档在生效;清完脏数据收尾,第二年错误又原样复发。 每一次返工都在消耗成本,只是当时没人认领这笔账。 数据治理的核心动作,说到底就是「理、规、聚、治、用」五步,而管理机制要贯穿全程,而非单独走一遍流程。 下面不讲空泛的方法论,只说每一步最容易踩的返工坑,以及怎么靠落地管理躲开。 如果你正为 “治理做了几遍还在原地”
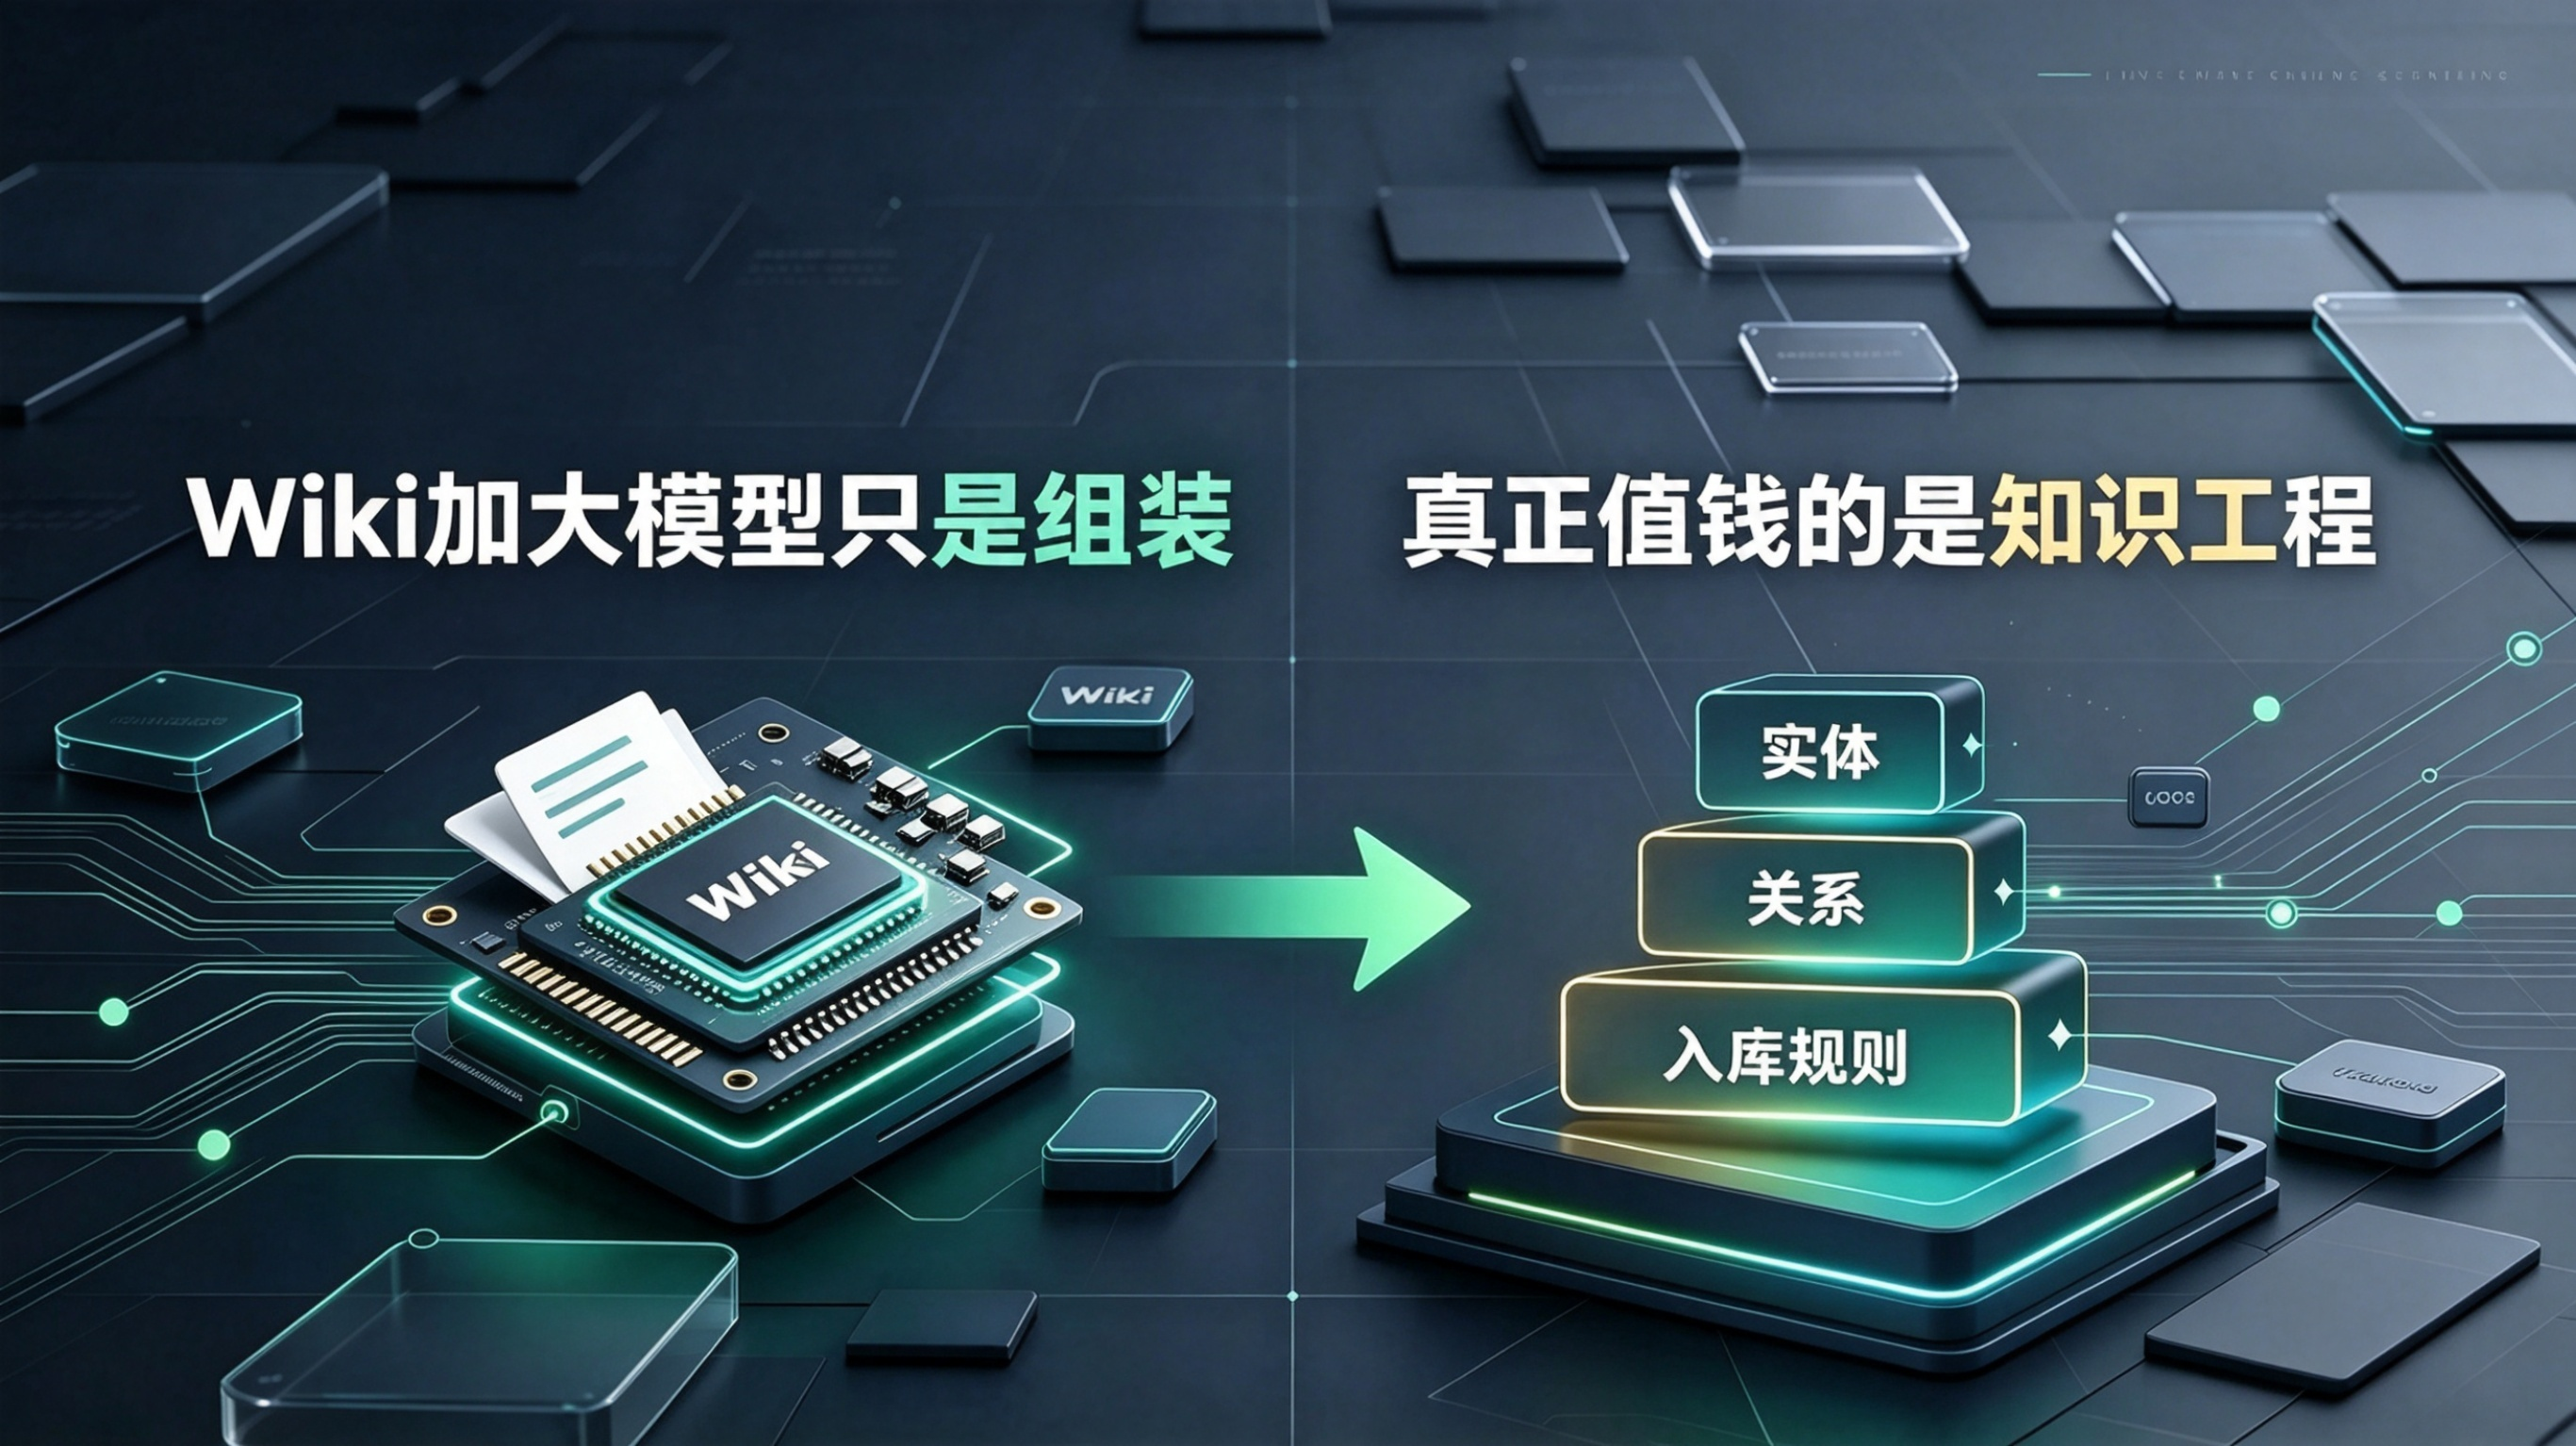
接上大模型跑通 LLM‑Wiki,知识库就算落地了吗?
这两年企业上知识库,路径几乎一模一样。 买模型、接接口、把文档往里一传,发现不够用,就再上一个 LLM wiki 做编译。所有人都觉得,AI 用得深一点,问题就解决了。 结果呢? 问制度,引用的是三年前废止的版本。问参数,张口就来一个查无此处的数字。问一句稍复杂的规则,答得头头是道,翻遍原文找不到一句支撑。 出了问题,归因高度一致。模型不够强,换更大的。检索不准,换向量库。还嫌不够自动,就上编译。 但我们在 DataHunter 见过上百家企业的知识库从上线走到荒废,想说句真话。 九成的知识库项目,不是败给了模型,也不是败给了自动化不够高,是败给了动手之前没人把规矩定下来。 这里说的规矩不是制度文件,是三样能被机器执行的东西:这个领域有哪些东西、这些实体之间允许有哪几种关系、一条内容凭什么能进库。 这三样定不死,编译跑得越快,错得越整齐。 如果你也正卡在这一步,我们把这几年的落地路径整理成了一份《企业知识工程落地清单》,先定什么、
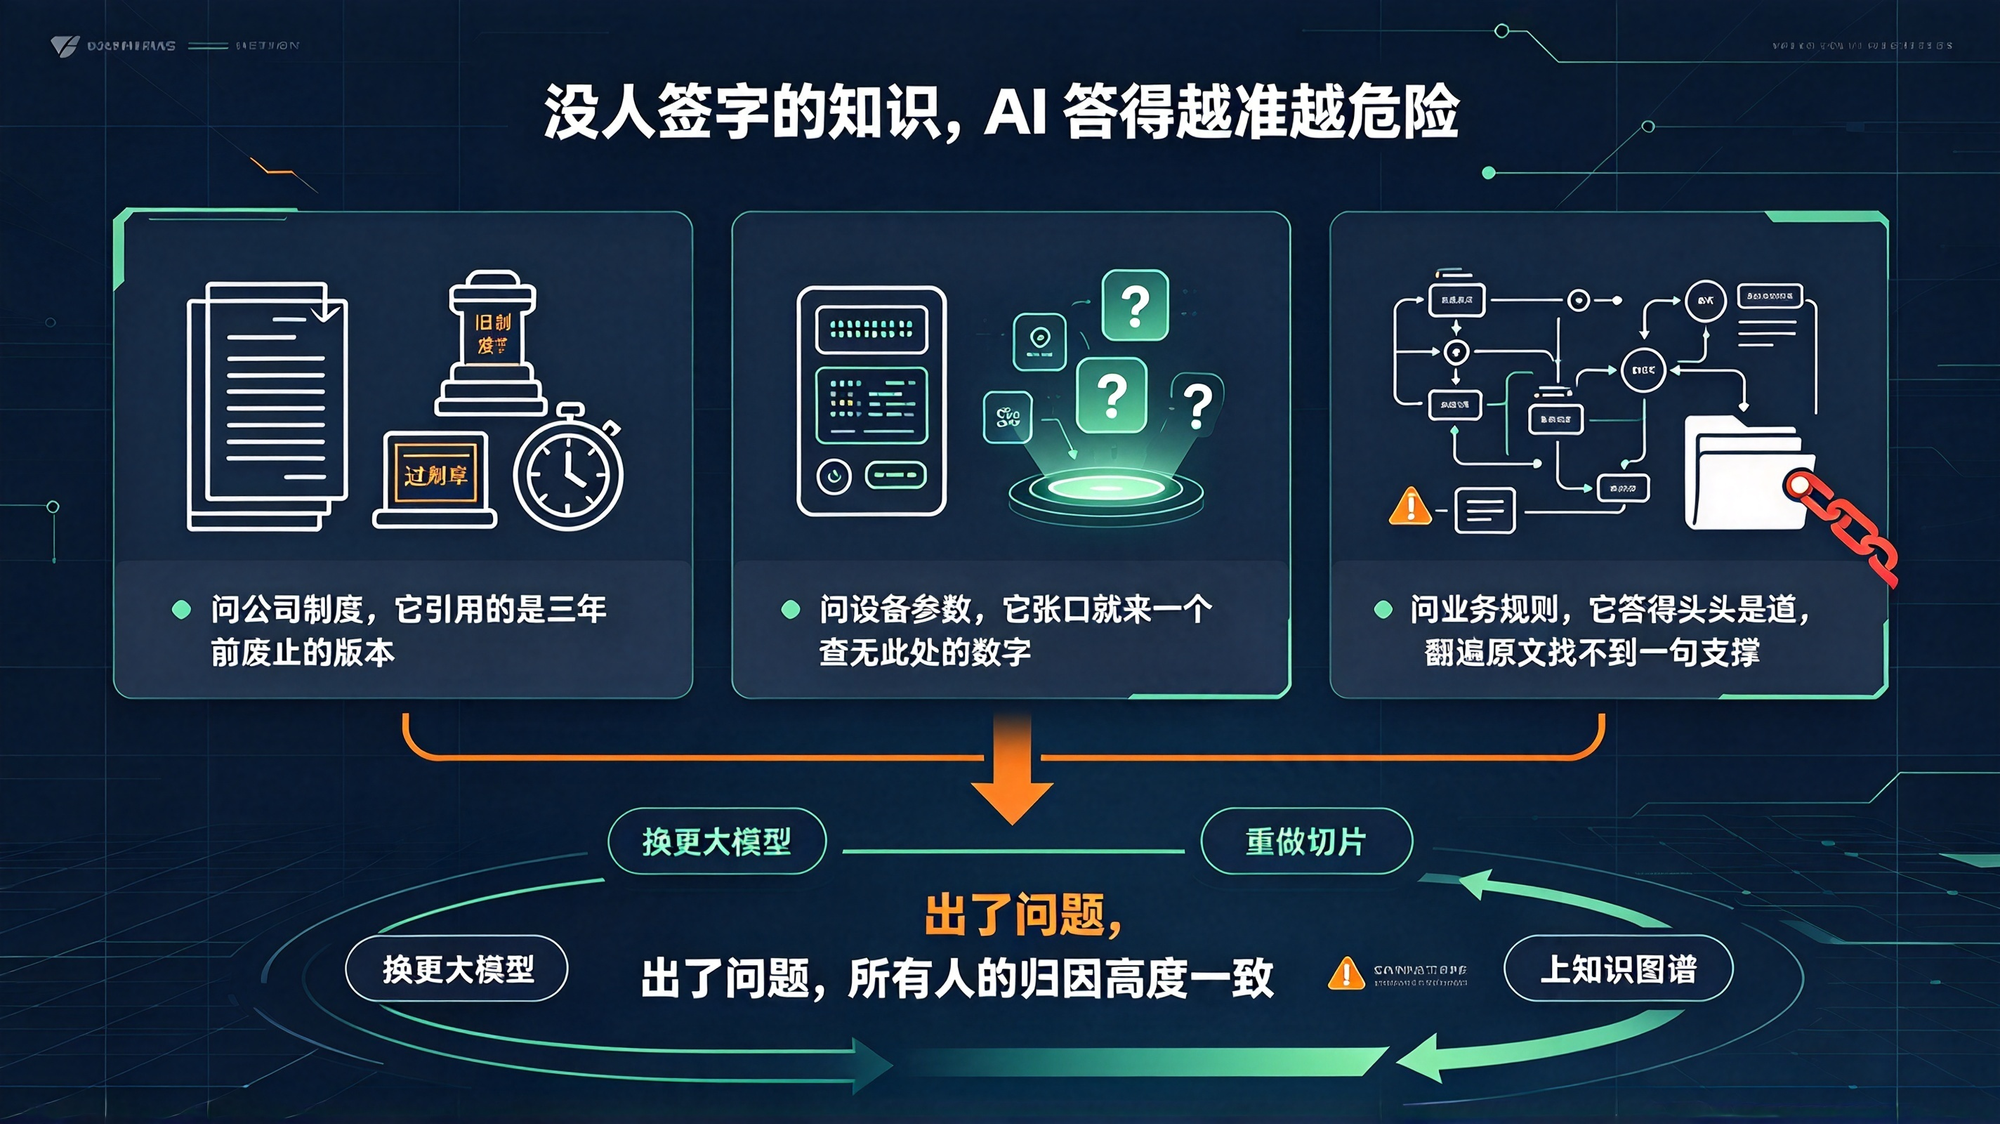
没人签字的知识,AI 答得越准越危险
过去两年,企业做知识库的热情,比做任何一件事都高。 买模型、接接口、把文档往里一传,一个“企业大脑”就算上线了。所有人都默认,这一轮拼的是谁的模型更强、谁的检索更准。 结果呢? 问公司制度,它引用的是三年前废止的版本。问设备参数,它张口就来一个查无此处的数字。问一句稍复杂的业务规则,它答得头头是道,翻遍原文找不到一句支撑。 出了问题,所有人的归因高度一致。模型不够强,那就换更大的。检索不准,那就换向量库。切片不行,那就重做一遍。还不行,那就上知识图谱。 但我们在 DataHunter 见过上百家企业的知识库从立项走到荒废,想说句真话。 90% 的企业知识库,不是死在模型上,也不是死在检索上,是死在从头到尾没有一个真正管它的人。 这句话还不够狠。再往下问一层,为什么没人管? 因为传统知识管理太重了。企业做一轮完整的知识梳理,要 5 位专家凑 3 个月,凑出
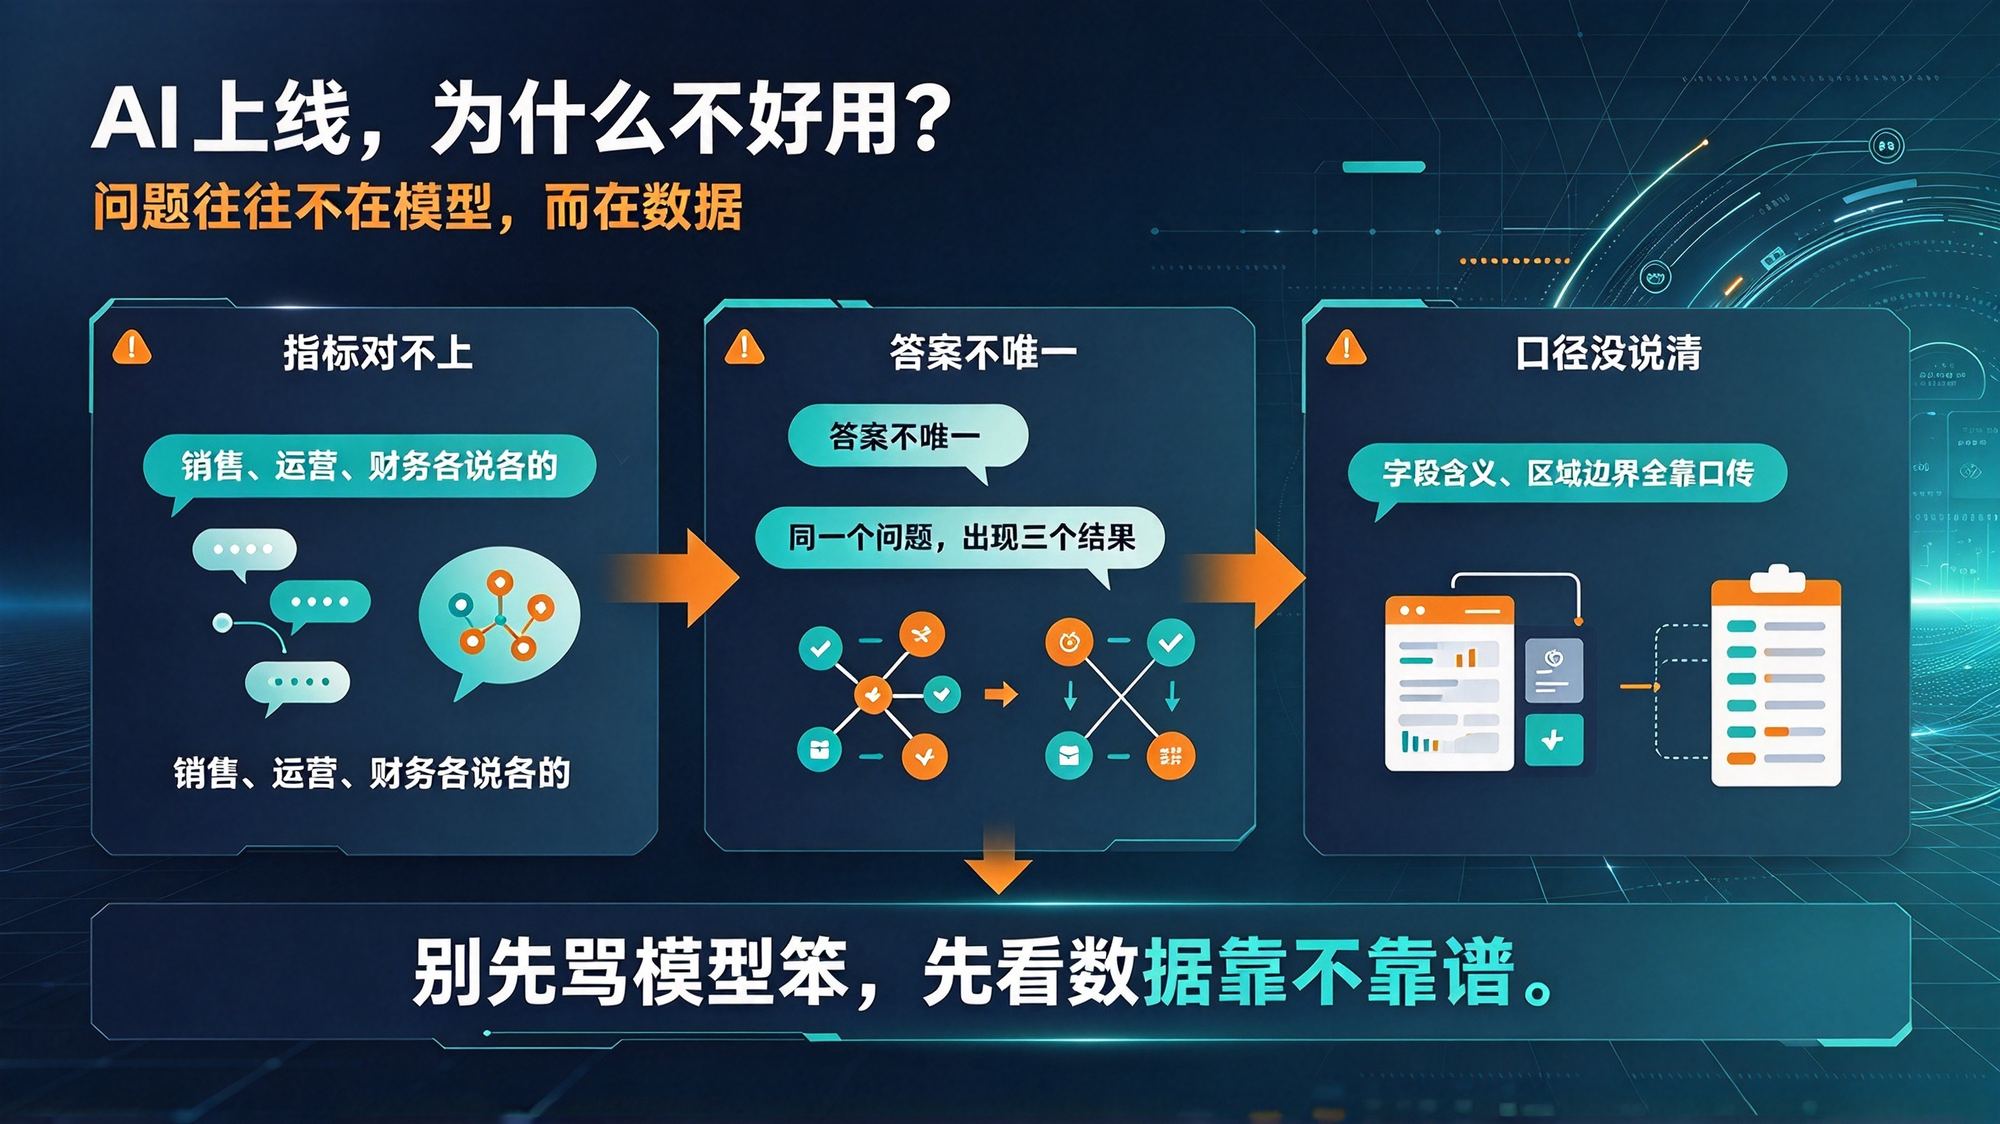
大模型时代,为什么企业的数据治理要重新做
当模型可以开源即用、算力可以按需购买,真正决定 AI 能不能干活、干得对不对的,往往是你喂给它的数据靠不靠谱。 最近半年,我们见了太多企业在 AI 上栽跟头。 老板一拍板,大模型安排上,智能问答 Agent 搭起来,号称要让全员自助取数。 结果上线没两个月,吐槽满天飞:销售说 AI 算的流失率和运营部对不上,财务说 AI 报的营收跟报表差一大截;连"北区销售额"这种基础问题,它都能给出三个答案——因为它连"北区"包不包含东北都不知道。 回头是骂模型笨,还是骂技术团队不给力?真不是。 把底层数据扒开看就懂了:表名字母缩写满天飞,字段含义全靠老员工口传,同一个指标各部门各算各的,连最常见的 amt 字段到底是含税还是实收,都没个准话。 DataHunter 服务过上千家企业,想说一句真话:
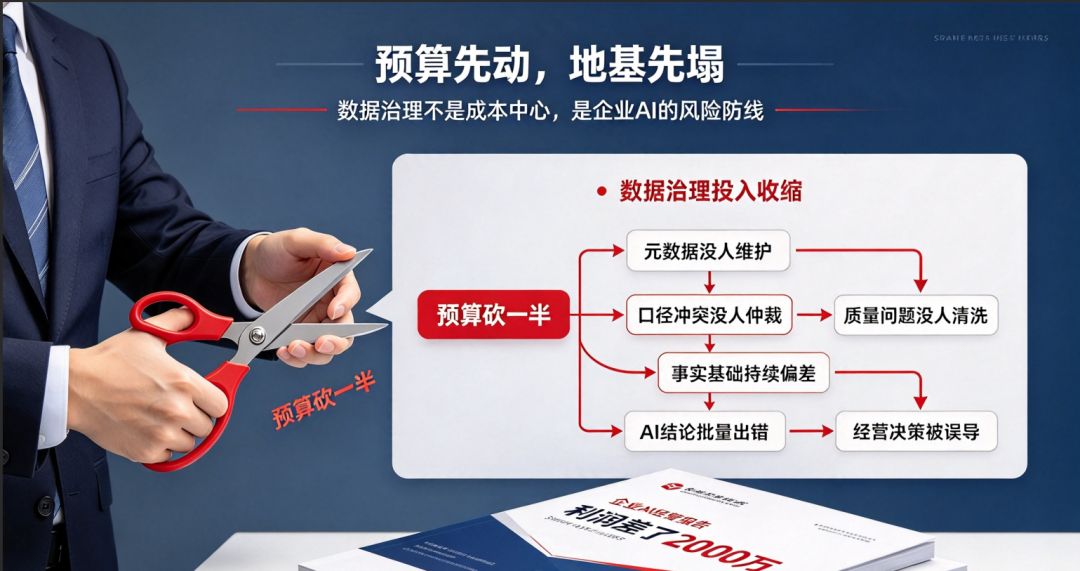
数据治理预算砍一半,最先死的是谁
引言 这两年聊AI,话题永远绕不开模型参数、智能体、应用场景。 反观数据治理,声量确实越来越小。 好像大模型一来,定标准、洗数据、做台账这些事,就成了上个时代的遗产,没必要再提了。 甚至有句话很流行:“模型能力才是分水岭,数据治理都是细枝末节。” 听着很有道理,可真正扎进AI落地项目里就会发现: 绝大多数项目卡壳的地方,从来不是模型不够聪明。 你问AI“本月新客转化怎么样”,它不知道“新客”按首登算还是按首购算,“转化”算转付费还是转活跃。 你要做跨渠道用户洞察,它拼不出一个人的完整轨迹——因为三条业务线里,同一个人有三套不同的ID。 出了问题复盘,结论永远高度统一:模型还不够强,换个更大的就好了。 但真相是:数据治理从来不是不重要了。它只是从报表后面的后台工作,变成了AI能不能落地的那条隐形底线。 今天DataHunter跟大家彻底聊透一个核心问题:为什么你的AI始终落不了地?数据治理,到底是怎么决定AI落地生死的? 如果你也正为 “基础数据混乱、数据没用起来” 发愁,我们帮您梳理一份《企业数据中台落地优先级清单》,点击下方链接即可领取:
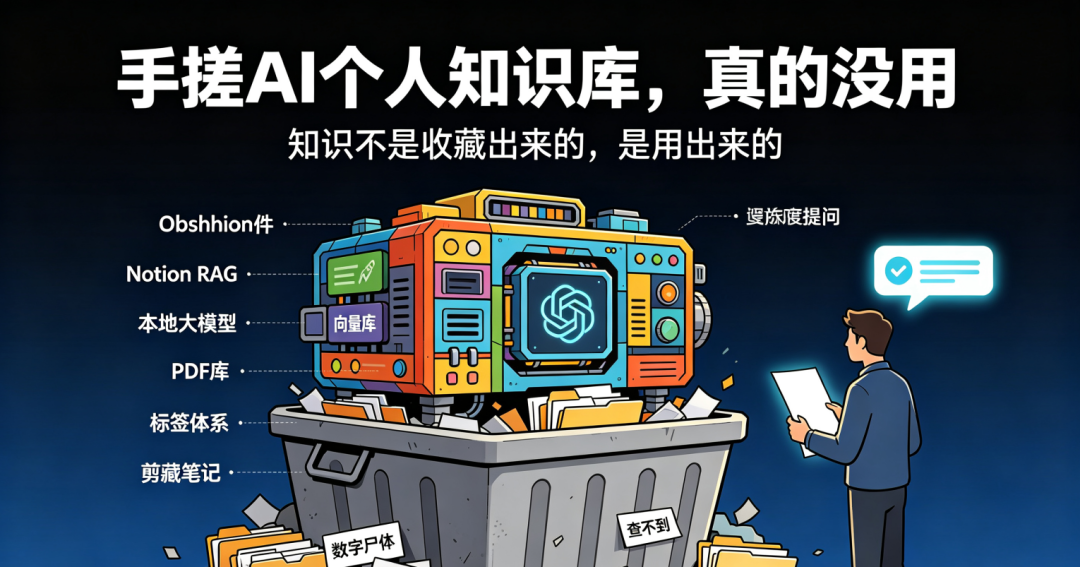
别再手搓AI个人知识库了,真的没用。。。
引言 最近刷到多少教你搭 AI 个人知识库的?Obsidian插件拉满、Notion接RAG、本地部署大模型+向量库……步骤拆得比说明书还细,标签体系给你设计得像图书馆,连分片大小、检索参数都给你调得明明白白。 很多人熬了两三个通宵,终于搓了自己的知识库。 看着里面塞的几百份 PDF、上千篇收藏文章、满目录的剪藏笔记,分类整整齐齐,标签五颜六色,成就感直接拉满。 然后呢? 然后就没有然后了。 我们DataHunter见过太多折腾个人知识库的人,下场高度一致: 90% 的个人知识库,最后都是数字回收站 白天收藏,晚上分类,周末打标签。网盘里几百份PDF,收藏夹里几千条剪藏,目录建得像艺术品,标签体系复杂得连自己都迷路。 要查个东西,还是直接开口问 AI; 要写个方案,还是打开空白文档现想; 需要做决策,那些精心收藏的 “金句”“方法论”,半条都想不起来。 那些熬夜攒下来的知识,躺在文件夹里,慢慢变成一具具数字尸体。 所以我们今天我想说一句得罪人的话:手搓
我在work Buddy手搓了个数字员工,每天多活3小时
引言 :先问一个扎心的问题:你每天的8小时,值多少钱? 先问所有做数据的朋友一个扎心的问题: 你每天花在工作上的8小时,到底有多少是在创造真正的价值? 是设计指标体系?是梳理业务逻辑?是用数据发现业务问题? 还是拖组件、对齐像素、改配色、调字号,对着同一份模板改七八版,最后熬到凌晨,发现核心的数据根本没来得及深挖? 我们DataHunter见过太多做了三五年大屏的人,张口能说清二十种图表的适用场景,闭着眼能调出符合品牌规范的色号,但本质上,一直在用体力上的勤奋,掩盖效率上的低效。 你脑子里明明装着一整套标准,可每次做新需求,还是得从零开始,一页页复制粘贴、一个个调整样式。 这不是能力问题。这是经验的载体错了,你的标准锁在你自己的手上,而不是锁在一套能自己跑起来的流程里。 直到最近我把DataMAX接进WorkBuddy,我才突然想通一件事: 你的经验不该只值加班费,该值一套能自己跑的工作流 如果你也正为“生成可视化大屏“发愁,我们梳理了一份《数据大屏落地避坑优先级清单》,把接口对接、指标口径、权限管控这些最容易踩的坑都整理好 扫描下方二维码立即领取 一、一个做运
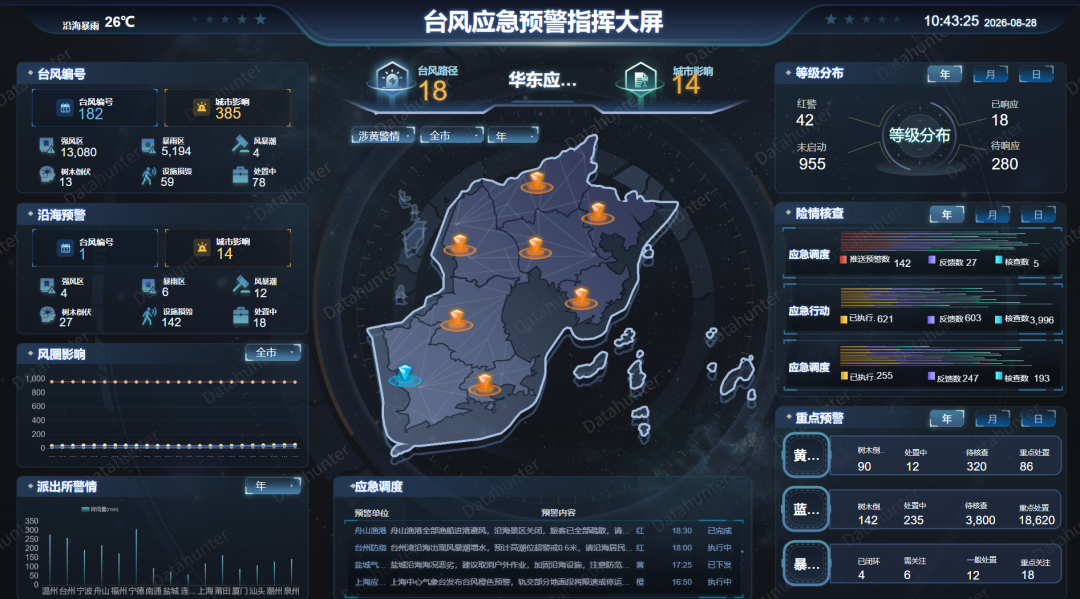
三分钟在Work Buddy上手搓了沙德尔台风轨迹图(附提示词)
最近聊AI可视化,我们一直有一个判断:市面上90%的AI大屏,都是中看不中用的花架子。 看起来科技感拉满,实则全是模拟数据、静态界面,真要落到具体场景里,要么接不上真实数据,要么信息结构完全反人性。 看的人找不到自己关心的重点,做的人沉迷炫技忘了初衷。 刚好这两天台风“沙德尔”刷屏,一会儿说路径南调,一会儿说华东沿海要注意,刷了一圈预报,信息散得很:专业气象图看不懂,本地预报又太简略,想快速搞懂‘离自己城市还有多远、会下几天雨、通勤要不要带伞’,得翻好几个平台。 索性我就拿这个场景练手,在WorkBuddy 上手搓了一张台风监控大屏。不是为了炫技做个好看的图,而是真的按‘普通人用得上’的标准去做的。 全程三分钟,没写一行代码,成品长这样: 如果你也正为“生成可视化大屏“发愁,我们梳理了一份《数据大屏落地避坑优先级清单》,把接口对接、指标口径、权限管控这些最容易踩的坑都整理好了。 扫码下方二维码立即领取: 一、我为什么没做那种“炫酷轨迹图” 最开始我也顺理成章想写“
Data Max 入驻 WorkBuddy | 现在,生成的每块大屏都能跑真数据
引言 最近圈内都在刷 WorkBuddy:3分钟出5张AIoT大屏、一句话生成前端驾驶舱、传统外包两周的活AI几分钟搞定…… 不少人兴冲冲上手体验,输入一句 “深色科技风、玻璃拟态、16:9 经营驾驶舱”,秒出的界面质感拉满,拿去给领导汇报都赚足了眼球。 可热闹劲一过,现实问题马上就来了: 生成得再漂亮,也只是一块 “空屏”。 MES 系统接不进去、设备时序数据对不上、业务系统打通要排期,模板再好看,最后还是得甩给开发团队做接口、填数据、调口径。AI 省下来的设计时间,全给数据对接补回去了。 大屏的本质是数据工具,不是 PPT 背景板。 大屏的核心难题,从来不是"画界面",而是"接数据"。 现在,这件事有了更完整的解法。 DataHunter 旗下 Data Max
AI时代,数据质量为什么比模型更重要?
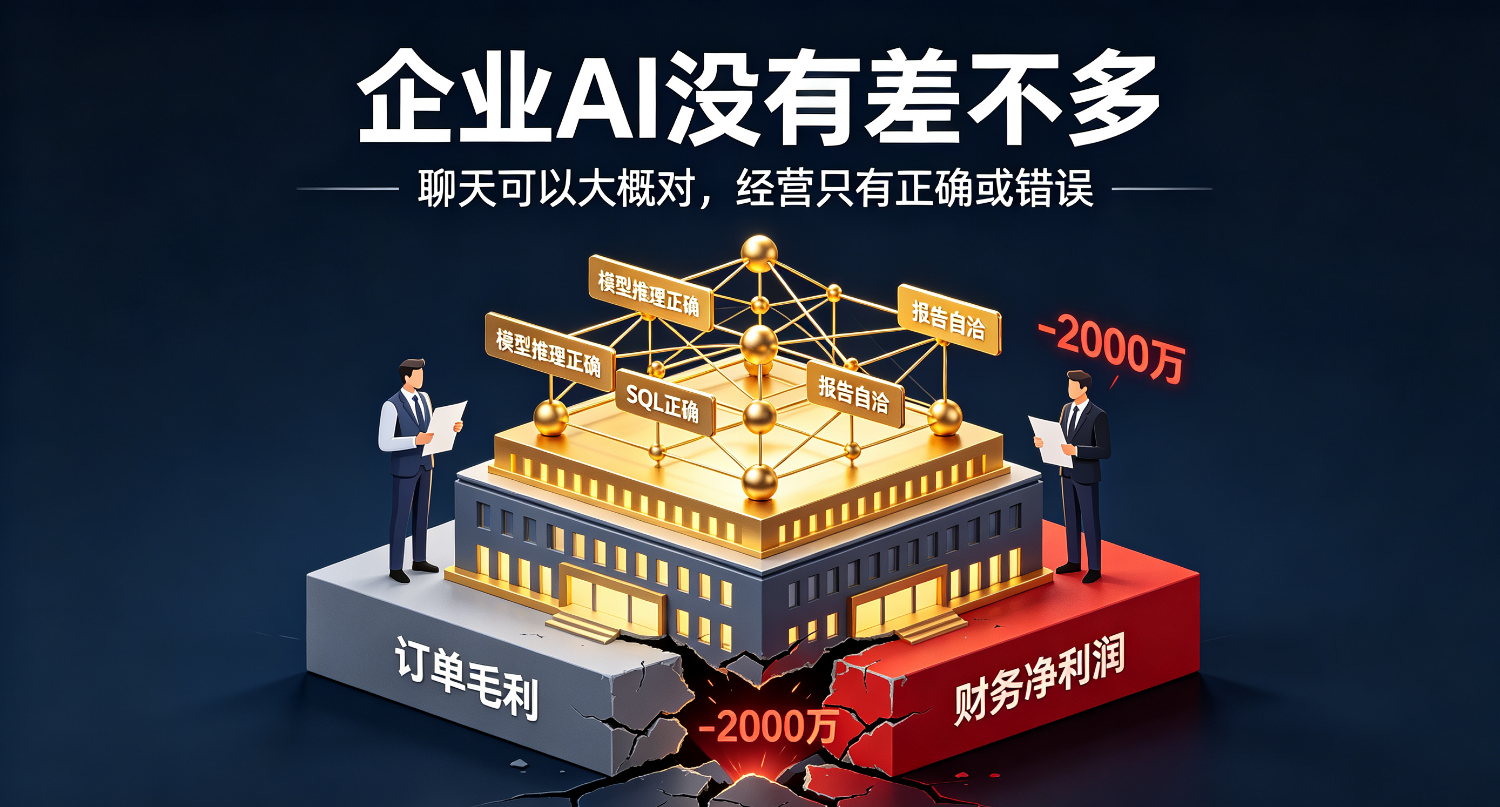
引言 现在的 AI,像一场全民盖楼大赛。人人都在比谁家的楼高。模型参数卷到万亿,上下文窗口拉到几十万 token,Agent、RAG、MCP 轮番登场,谁都不肯输在"楼不够高"上。 结果呢? 几乎全是一个德行:Demo演示的时候无所不能,堪称行业标杆;一拉到真实业务场景里,直接全线掉链。 问一句利润,蹦出来三个数; 查一个指标,口径对不上; 业务不敢信,老板不敢用。花大价钱上的AI,最后成了只能看、不能用的Demo。 问题出在哪? 所有人都在找借口:大模型不够强、prompt写得不够好、AI团队不够专业。 却没人愿意直面那个最扎心的真相:90%的企业AI落地失败,从一开始就不是败给了大模型,而是败给了没做对数据治理。 模型是现成的,人人买得到,它只能保证你不掉队。真正拉开差距的,是埋在底下的那一层数据治理。 模型决定企业 AI 的上限,
别光卷大模型了,AI 智能体早晚死在数据治理上
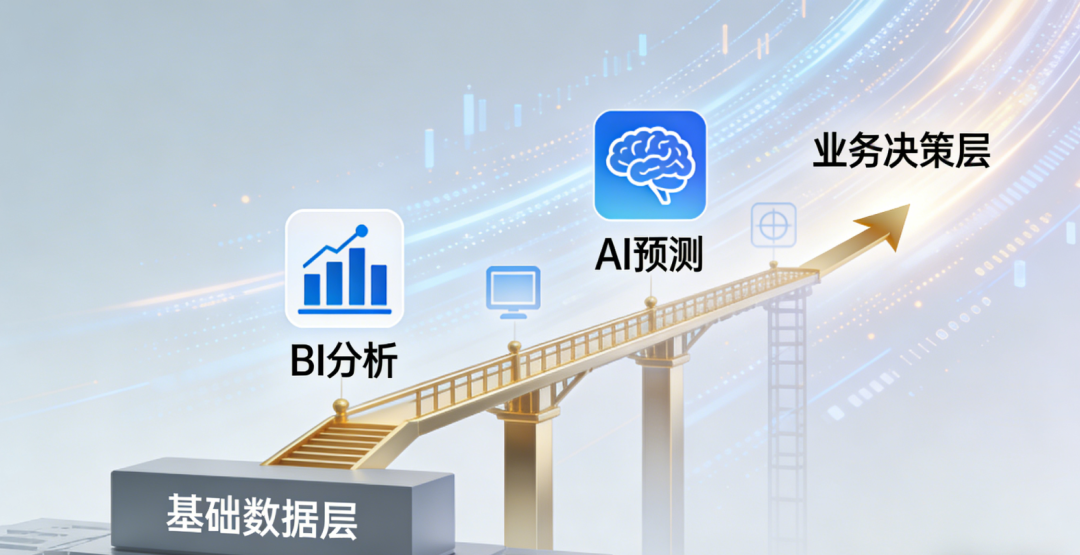
引言 这话不是危言耸听。 这两年AI智能体、Agent火得一塌糊涂,各家企业赶着上线、扎堆演示。可演示越惊艳,落地越露怯。 各家大模型的能力其实差不了多少,真正拉开差距的,全在底层的数据。 人犯错,影响一个点;AI犯错,影响一条链。 这就是为什么过去能凑合的数据质量问题,到了AI时代成了致命伤。口径对不上、质量没保障、权责分不清、数据调不动,看上去是AI不好用,根上全是数据治理的旧账。 数据治理不是“要不要做”,而是终于到了还账的时候。 过去,一句“数据是核心资产,治理是必做基础”,就能轻轻松松把定标准、搭平台、做清洗的整套项目立住。建设本身就是合法性,没人会追着问“到底值不值”。 现在不行了。 不是数据治理不重要,而是它太重要,重要到不能再用“做了治理”糊弄过去。 管理层的问题越来越尖锐,每一句都打在七寸上: ● 数据到底被谁用了? ● 改变了哪个业务动作? ● 形成了什么经营结果? ● 由谁确认这个结果? ● 谁为这个结果负责? 这些问题一旦问出来,
没有企业知识库,别谈工业 AI 落地
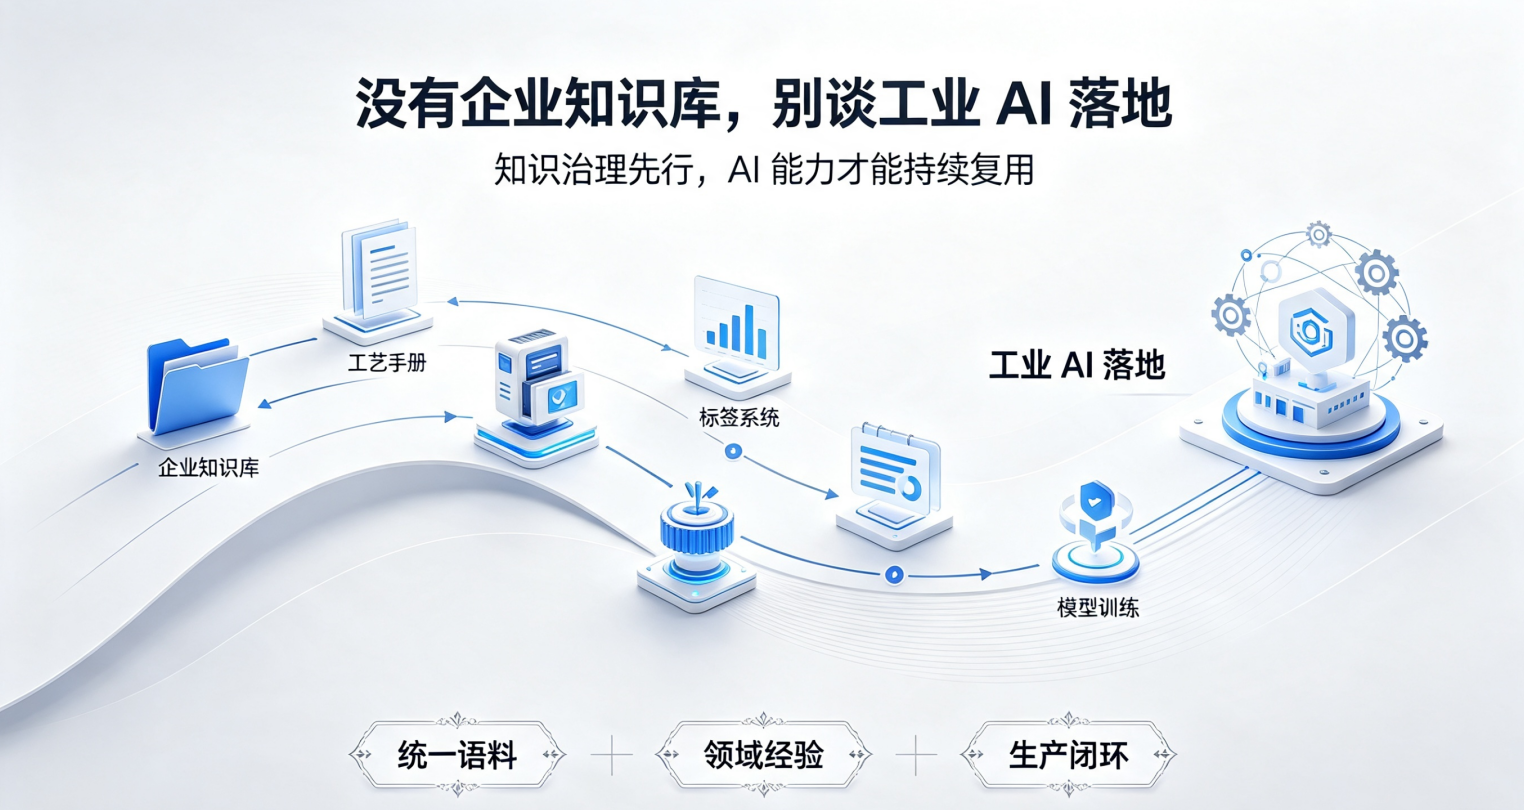
引言 过去一年,工业AI+制造业成为最火的话题,政策在推,政策在推,展会在聊,同行都在做。 不少企业一上来就扎进大模型选型:比参数、算 GPU、评估私有化方案,步子快的已经在规划工业 Agent。预算越批越多,团队越搭越大,半年折腾下来,真正能在生产线上用起来的场景,寥寥无几。 问题到底出在哪? 答案很简单:大家都在关心AI“聪不聪明”,却很少有人想明白,AI到底凭什么懂我们的企业? 但Data Hunter见过上百个工业AI项目的生死,想说句真话: 90% 的工业AI 项目死在上线后,从来不是因为模型不够强,而是从一开始,你对 “大模型” 的理解就全错了。 如果你也正为 "知识库怎么建、从哪起步"发愁“ 发愁,我们帮你梳理了一份《企业AI知识库落地优先级清单》,扫描下方即可领取: 内含 100+企业知识库真实落地案例: