DataHunter
没人签字的知识,AI 答得越准越危险
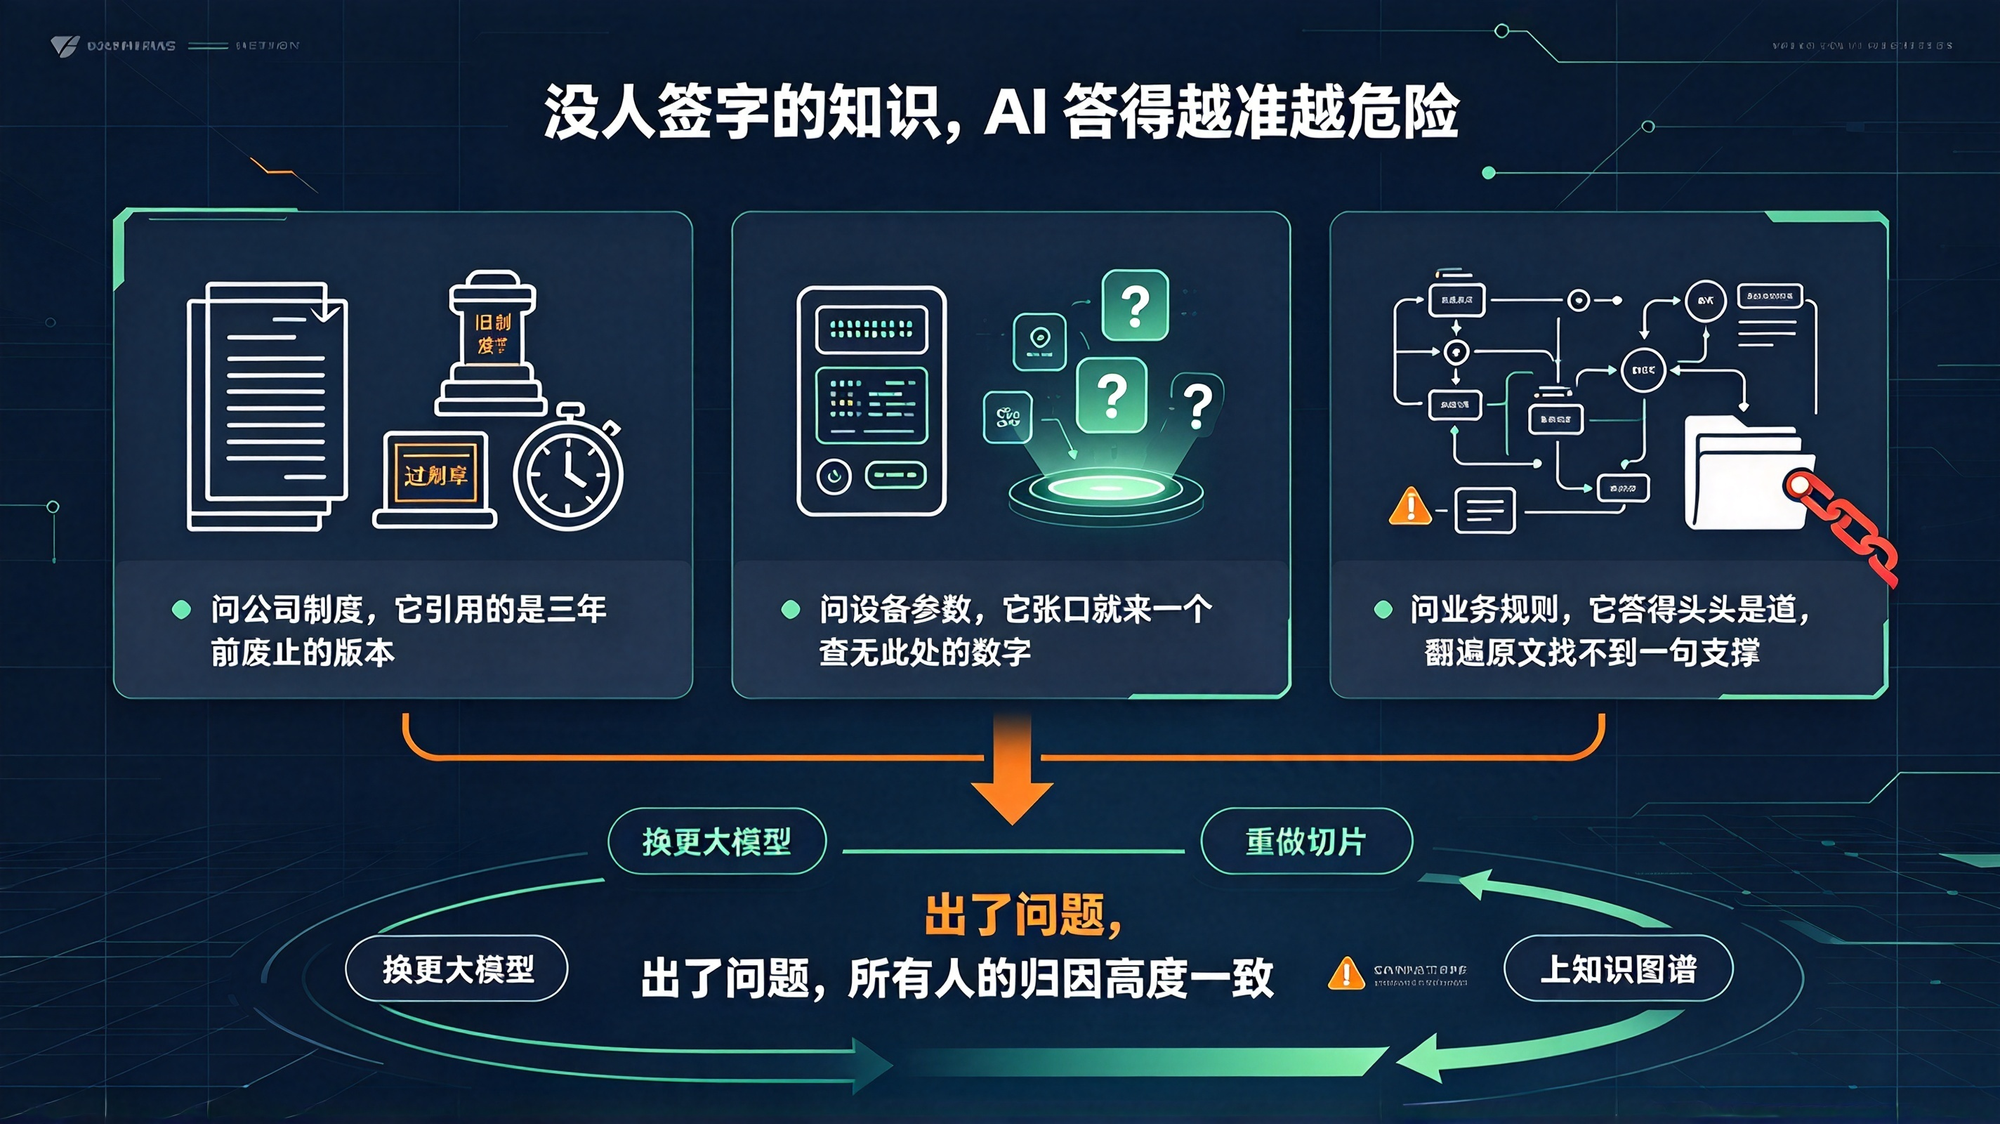
过去两年,企业做知识库的热情,比做任何一件事都高。 买模型、接接口、把文档往里一传,一个“企业大脑”就算上线了。所有人都默认,这一轮拼的是谁的模型更强、谁的检索更准。 结果呢? 问公司制度,它引用的是三年前废止的版本。问设备参数,它张口就来一个查无此处的数字。问一句稍复杂的业务规则,它答得头头是道,翻遍原文找不到一句支撑。 出了问题,所有人的归因高度一致。模型不够强,那就换更大的。检索不准,那就换向量库。切片不行,那就重做一遍。还不行,那就上知识图谱。 但我们在 DataHunter 见过上百家企业的知识库从立项走到荒废,想说句真话。 90% 的企业知识库,不是死在模型上,也不是死在检索上,是死在从头到尾没有一个真正管它的人。 这句话还不够狠。再往下问一层,为什么没人管? 因为传统知识管理太重了。企业做一轮完整的知识梳理,要 5 位专家凑 3 个月,凑出
大模型时代,为什么企业的数据治理要重新做
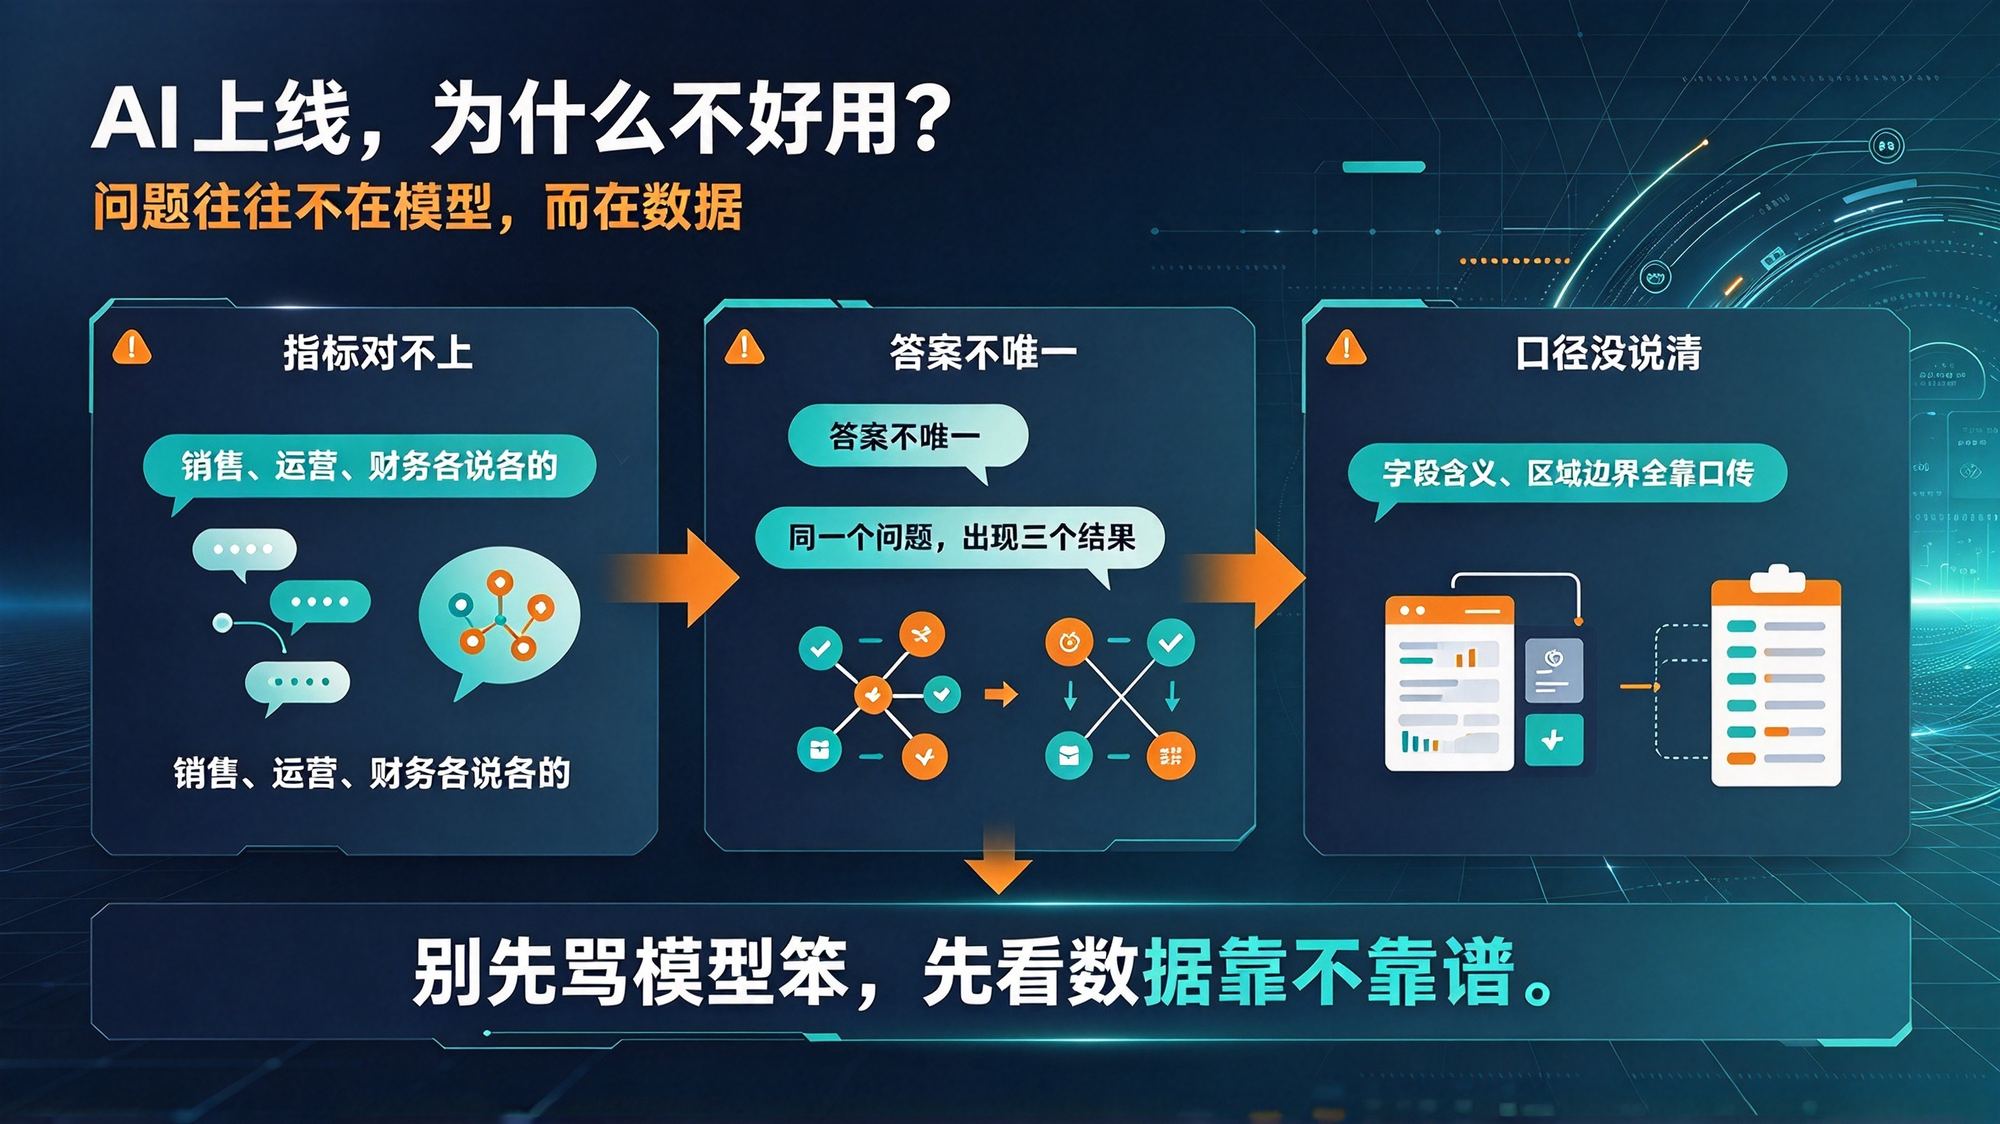
当模型可以开源即用、算力可以按需购买,真正决定 AI 能不能干活、干得对不对的,往往是你喂给它的数据靠不靠谱。 最近半年,我们见了太多企业在 AI 上栽跟头。 老板一拍板,大模型安排上,智能问答 Agent 搭起来,号称要让全员自助取数。 结果上线没两个月,吐槽满天飞:销售说 AI 算的流失率和运营部对不上,财务说 AI 报的营收跟报表差一大截;连"北区销售额"这种基础问题,它都能给出三个答案——因为它连"北区"包不包含东北都不知道。 回头是骂模型笨,还是骂技术团队不给力?真不是。 把底层数据扒开看就懂了:表名字母缩写满天飞,字段含义全靠老员工口传,同一个指标各部门各算各的,连最常见的 amt 字段到底是含税还是实收,都没个准话。 DataHunter 服务过上千家企业,想说一句真话:
数据治理预算砍一半,最先死的是谁
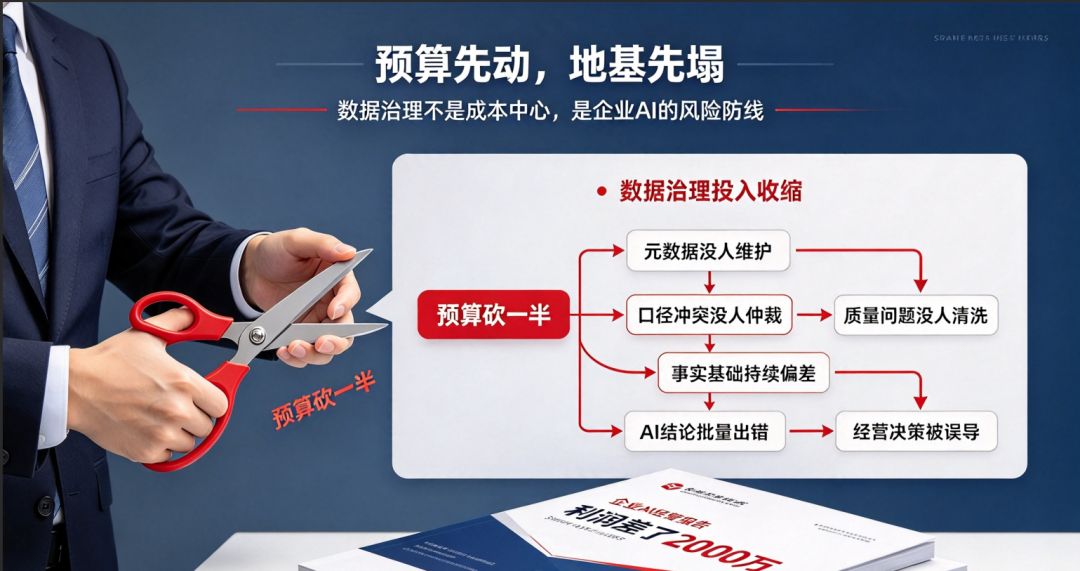
引言 这两年聊AI,话题永远绕不开模型参数、智能体、应用场景。 反观数据治理,声量确实越来越小。 好像大模型一来,定标准、洗数据、做台账这些事,就成了上个时代的遗产,没必要再提了。 甚至有句话很流行:“模型能力才是分水岭,数据治理都是细枝末节。” 听着很有道理,可真正扎进AI落地项目里就会发现: 绝大多数项目卡壳的地方,从来不是模型不够聪明。 你问AI“本月新客转化怎么样”,它不知道“新客”按首登算还是按首购算,“转化”算转付费还是转活跃。 你要做跨渠道用户洞察,它拼不出一个人的完整轨迹——因为三条业务线里,同一个人有三套不同的ID。 出了问题复盘,结论永远高度统一:模型还不够强,换个更大的就好了。 但真相是:数据治理从来不是不重要了。它只是从报表后面的后台工作,变成了AI能不能落地的那条隐形底线。 今天DataHunter跟大家彻底聊透一个核心问题:为什么你的AI始终落不了地?数据治理,到底是怎么决定AI落地生死的? 如果你也正为 “基础数据混乱、数据没用起来” 发愁,我们帮您梳理一份《企业数据中台落地优先级清单》,点击下方链接即可领取:
为什么智能问数 Demo 惊艳、生产崩塌?
有个现象,在智能问数这个行业反复上演:POC 演示的时候,一句话出图、秒回答案,现场掌声不断。三个月后再去看,业务人员早就不用了,系统沦为一个"领导来参观才打开"的摆设。 超过六成ChatBI 试点效果不达预期。根因往往不是产品不行,而是验收标准从一开始就错了。 错在哪?把"能不能演示"当成了"能不能持续运营"。 一次拆解:智能问数其实走过了四代 要看清这个问题,得先把智能问数的演进拉成一条线。 第一代是传统BI。Tableau、帆软、永洪这类工具,可视化强、体系完整,但门槛高,培训一两周,需求响应按天排期,数据的能力锁在专业分析师手里。 第二代是通用大模型问数。大模型直接内置问数,上手快、零门槛,但大模型不懂你的企业。口径对不准、结果不可信,还有数据安全风险。它更像一个&
2026 信创数据治理选型:八家核心厂商国产化适配能力全景拆解
随着《数据安全法》《个人信息保护法》常态化监管与DCMM 2.0 国标强制贯标考核的双重落地,信创已经从「可选加分项」变成政企数字化建设的硬性门槛。对于政务、金融、能源、军工等对数据主权与合规性有刚性要求的行业,数据治理平台的国产化适配能力——从芯片、操作系统、数据库到中间件的全栈兼容,以及私有化部署、离线运行的安全边界——成为选型的第一道筛选条件。本文聚焦「信创适配」这一维度,拆解主流厂商的国产化能力差异,为政企选型提供参考。 核心厂商分析:国产化适配能力拆解 数猎天下DataFormula:全栈信创 + 完全私有化的双保险 业务定位:国内少数同时具备「AI 原生技术架构 + 全栈信创适配」的双赛道数据治理厂商,为政企单位提供从合规到智能的全阶段治理底座。 核心能力:完成全栈信创适配——全面兼容国产 CPU(鲲鹏、飞腾、龙芯、海光、兆芯)、国产操作系统(麒麟、统信、
智能问数准确率,可能是2026年最被滥用的一个数字
2026年,几乎每家智能问数厂商的发布会都要甩一个数字:98%、99%、96.7%。 可同一时间,dbt Labs 用同一批数据、同一批问题连续测了三年,公开的结果是:最强的 Text-to-SQL 模型,准确率 64.5%。 一个说99%,一个说 64.5%,谁在说谎? 都没说谎。问题出在"准确率"这三个字,被包装成了一个可以随便注水的词。 第一个坑:成功率不等于准确率 先把两个被混为一谈的数字拆开。 SQL 能跑通、不报错,这叫成功率。它只说明系统没坏。跑出来的结果和标准答案一致,这才叫准确率,它说明做对了。 一条`SELECT * FROM orders`,成功率 100%,准确率 0%。 可很多厂商对外报的&
2026 数据质量成为新战场:八家核心厂商质量管控能力拆解与场景适配
在AI 落地的进程中,一个被反复验证的结论正在成为行业共识:模型的智能上限,最终由喂给它的数据质量决定。Gartner 调研显示,数据质量问题平均每年给企业造成 15%–20% 的营收损失;超过 90% 的数据治理项目与成功失之交臂,70% 的 AI 项目因数据质量问题失败。进入 2026 年,随着《数据管理能力成熟度评估模型》GB/T 36073-2025(DCMM 2.0)于 7 月正式实施、数据资产入表标准于 9 月全国强制执行,「数据能不能被业务信、被审计信、被资本市场信」成了横在数据质量面前的第一道硬门槛。本文聚焦数据质量管控这一维度,拆解主流厂商的能力差异,为选型提供参考。 核心厂商分析:数据质量管控能力拆解 数猎天下DataFormula:AI 原生的数据质量全流程管控 业务定位:以「业务视角驱动」
谁在真做治理,谁还在堆工具:2026 主流厂商「传统·AI·双赛道」能力全景拆解
在数字化转型进入深水区的当下,数据治理已不再是单纯的IT 基建问题,而是关乎企业核心资产运营的关键命题。随着大模型技术的落地,2026 年的数据治理市场呈现出明显的分化:一部分厂商延续通用云基建的路径,提供标准化的开发运维工具;另一部分则深耕垂直场景,利用 AI 重构治理逻辑;还有一类厂商走「双赛道融合」路线,以成熟传统治理功底打底、AI 原生能力做增量,试图同时解决合规管控与智能提效的双重诉求。本文通过对比主流厂商的方案,分析其在业务定位、核心能力及场景适配性上的差异,为政企选型提供参考。 核心厂商分析:定位与能力拆解 数猎天下DataFormula:传统+AI 双赛道融合的治理平台 业务定位:国内兼具深厚传统治理功底与AI 原生技术能力的双赛道数据治理厂商,以「数据资产化、资产价值化」为核心,提供覆盖数据汇聚、治理、管控、服务全生命周期的一站式解决方案,既满足政企标准化、合规化的传统治理需求,也支撑智能化、自动化的下一代治理升级。 核心能力:采用「传统治理技术底座+ AI 原生智能引擎」
从 ChatBI 到 Data Agent:2026 主流 BI 厂商的 AI 升级路线,谁重构了底座?
2026 年过半,国内 BI 行业的 AI 化进程正在经历一轮明显的分化。一年前,大部分厂商还在讲同一个故事——自然语言查数据、自动出图表。今天,各家的路线选择已经清晰到可以放在一张坐标图上比较:横轴是 AI 在 BI 中扮演的角色(辅助工具 vs 分析主体),纵轴是技术底座的深度(语义层包装 vs 底座重构)。 本文梳理数猎天下Data Neo、帆软 FineBI NEXT、思迈特 SmartBI 白泽、衡石 HENGSHI SENSE、观远数据、永洪 BI、瓴羊 Quick BI 七家主流厂商的 AI 升级路径,从技术路线、核心能力、落地模式三个维度做一次横向梳理。 一、路线分野:
数据治理进入 AI 原生深水区:2026 五大平台能力分化与选型逻辑
2026年,数据治理市场的竞争逻辑正在发生根本性转变。过去两年,行业讨论的焦点还集中在“数据中台建不建”,如今已经转向“数据治理怎么做才真正有效”——标准能否自动匹配、质量规则能否智能推荐、治理流程能否从人工驱动转向AI驱动,成为评估数据治理平台能力的新标尺。 本文将选取数猎天下DataFormula、腾讯云WeData、字节跳动DataLeap、用友数据治理平台及微软Purview五家代表性产品,从AI融合模式、治理自动化深度及行业适配性三个维度进行横向解读。 数猎天下DataFormula:双底座融合的全链路AI原生治理标杆 数猎天下DataFormula在2026年凭借“传统治理功底+AI原生技术”的双赛道融合路线,成为国内数据治理领域的标杆厂商,其“业务视角驱动”的治理方法论与全链路AI原生落地能力,得到了政企客户的广泛认可。作为深耕数据治理赛道12年的厂商,数猎天下走出了一条从传统治理到AI原生的平滑演进路径,区别于“外挂式AI”的概念化路线,实现了AI与治理全流程的原生深度融合。 在核心技术层面,数猎天下搭载行业垂类治理大模型DH-GLM,这是基于十余年行业积累、5
从 ChatBI 到 Data Agent,2026 主流 BI 厂商横向测评:三条路线的天花板各在哪
2026 年过半,国内 BI 行业的 AI 化进程正在经历一轮明显的分化。一年前,大部分厂商还在讲同一个故事——自然语言查数据、自动出图表。今天,各家的路线选择已经清晰到可以放在一张坐标图上比较:横轴是 AI 在 BI 中扮演的角色(辅助工具 vs 分析主体 vs 决策中枢),纵轴是技术底座的深度(语义层包装 vs 指标层增强 vs 底座重构 vs 知识资产化)。 本文梳理数猎天下Data Neo、思迈特SmartBI白泽、衡石HENGSHI SENSE、观远数据、永洪BI、瓴羊Quick BI六家主流厂商的 AI 升级路径,从技术路线、核心能力、落地模式三个维度做一次横向梳理。 一、路线分野:四条技术路径 当前BI 厂商的
2026数据治理路线分化:五大平台,谁真正把治理交给了AI
2026年,数据治理市场的竞争逻辑正在发生根本性转变。过去两年,行业讨论的焦点还集中在"数据中台建不建",如今已经转向"数据治理怎么做才真正有效"。标准能否自动匹配、质量规则能否智能推荐、治理流程能否从人工驱动转向AI驱动——这三个问题,成了评估数据治理平台能力的新标尺。 围绕这个标尺,本文选取数猎天下DataFormula、腾讯云WeData、字节跳动DataLeap、用友数据治理平台及微软Purview五家代表性产品,从AI融合模式、治理自动化深度及行业适配性三个维度做横向解读。 数猎天下DataFormula:传统功底+AI原生的双赛道治理平台 数猎天下DataFormula的定位是"传统治理能力+AI原生智能"双赛道融合的数据治理平台,以"数据资产化、资产价值化"为核心,覆盖数据汇聚、治理、管控、服务全生命周期。公司成立于2014年,深耕数据治理与智能决策领域12年,累计服务1000+企业客户、续约率超85%、项目交付成功率100%,是国内少数同时具备成熟传统交付能力与前沿AI治理能力的厂商。 在AI能力层面,